Confident AI
Compartir
Plataforma de evaluación de modelos de lenguaje para probar flujos de IA, medir métricas de calidad y automatizar pruebas en el ciclo de desarrollo sin depender de ingeniería.
Qué es Confident AI y para qué sirve
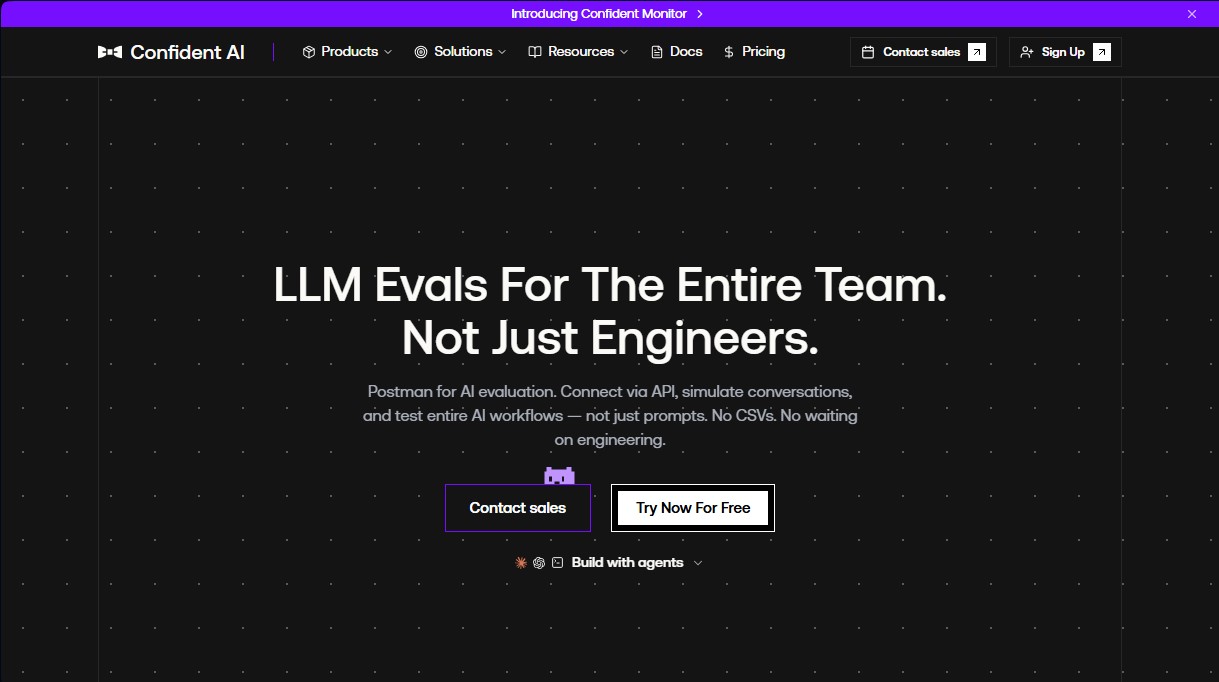
Confident AI es una plataforma avanzada de evaluación de LLM (Large Language Models) diseñada para equipos que buscan optimizar el rendimiento y la fiabilidad de sus aplicaciones de inteligencia artificial. A diferencia de las herramientas que solo analizan prompts aislados, esta solución permite testear flujos de trabajo completos y simular conversaciones multi-turno para detectar fallos que solo aparecen tras varios intercambios de mensajes. Su enfoque principal es eliminar el cuello de botella técnico, permitiendo que tanto ingenieros como Product Managers y expertos de dominio colaboren en la mejora de la calidad del sistema sin depender constantemente de cambios en el código.
El funcionamiento de la herramienta se asemeja al de Postman, pero especializado en inteligencia artificial. Los usuarios pueden conectar cualquier aplicación mediante puntos finales de API (endpoints) sin necesidad de modificar el código fuente ni instalar SDKs complejos. Una vez conectada, la plataforma permite definir un dataset de referencia (golden dataset) y seleccionar entre más de 50 métricas de evaluación respaldadas por la investigación académica y el marco de trabajo de código abierto DeepEval, utilizado por empresas líderes en el sector.
Entre las capacidades tecnológicas y funciones principales de Confident AI destacan:
- Métricas de evaluación LLM-as-a-judge: Utiliza modelos de lenguaje para calificar de forma automatizada aspectos críticos como la fidelidad (faithfulness), la relevancia de la respuesta, la detección de alucinaciones, la toxicidad y el cumplimiento del tono de marca.
- Experimentos comparativos (Side-by-Side): Facilita la comparación directa entre diferentes versiones de modelos, cambios en el sistema de prompts o ajustes en la lógica del pipeline, visualizando mediante deltas qué métricas mejoran y cuáles sufren regresiones.
- Simulación de usuarios y agentes: Genera interacciones automáticas de extremo a extremo para poner a prueba agentes de IA en escenarios reales, evaluando la coherencia y la resolución de tareas complejas.
- Alineación con el criterio humano: Permite comparar las puntuaciones automáticas con anotaciones humanas para identificar falsos positivos y asegurar que las métricas automáticas sean representativas.
Para el flujo de trabajo profesional, Confident AI se integra directamente en los procesos de integración continua (CI/CD). Esto permite establecer umbrales de calidad obligatorios que bloquean la subida a producción si se detecta una regresión en la calidad de las respuestas. Es compatible con los principales proveedores de modelos como OpenAI, Anthropic (Claude), Google Gemini y servicios de infraestructura como Azure OpenAI o AWS Bedrock.
Esta herramienta resulta de gran utilidad para empresas que necesitan desplegar soluciones de IA generativa seguras y escalables. Su ecosistema incluye un servidor MCP nativo que permite a los desarrolladores ejecutar evaluaciones y gestionar prompts directamente desde su ordenador mediante editores de código como Cursor, agilizando todo el ciclo de desarrollo.
Funciones y casos de uso de Confident AI
Cómo usar Confident AI
Preguntas frecuentes sobre Confident AI
¿Es necesario modificar el código de mi aplicación para empezar a usar Confident AI?
No es necesario realizar cambios en el código siempre que tu aplicación sea accesible mediante una API ya que puedes conectar cualquier punto de enlace de forma directa.
¿Qué tipo de métricas de evaluación ofrece Confident AI?
La plataforma incluye más de cincuenta métricas respaldadas por investigación que evalúan aspectos como la veracidad la relevancia de las respuestas y la presencia de alucinaciones.
¿Permite Confident AI realizar pruebas en conversaciones de varios turnos?
Sí la herramienta permite simular conversaciones completas de principio a fin para detectar fallos que solo aparecen tras varios intercambios de mensajes entre el usuario y la IA.
¿Pueden los gestores de producto utilizar la herramienta sin depender de ingenieros?
Efectivamente la plataforma está diseñada para que los perfiles no técnicos puedan ajustar prompts y ejecutar experimentos sin generar cuellos de botella en el equipo de ingeniería.
¿Con qué proveedores de modelos de lenguaje es compatible la plataforma?
Es compatible con los principales proveedores del mercado incluyendo OpenAI Anthropic y Google así como servicios en la nube como Azure OpenAI o AWS Bedrock.
¿Es posible integrar las evaluaciones de Confident AI en mi flujo de CI/CD?
Sí puedes configurar comprobaciones obligatorias en plataformas como GitHub Actions para bloquear de forma automática cualquier cambio que provoque una regresión en la calidad.
¿Cómo garantiza la herramienta que las evaluaciones automáticas coinciden con el criterio humano?
La plataforma permite comparar las puntuaciones de las métricas con anotaciones humanas para identificar falsos positivos y asegurar que los criterios de evaluación están alineados.
¿Existe alguna versión gratuita para probar las funciones de Confident AI?
Disponemos de un plan gratuito permanente que permite explorar las funciones de pruebas unitarias y el versionado de prompts sin ningún coste inicial.
¿Qué infraestructura de frameworks es compatible con la herramienta?
La solución se integra perfectamente con los entornos de trabajo más utilizados como LangChain LlamaIndex y Vercel AI SDK entre otros.
¿Se pueden realizar comparaciones directas entre diferentes versiones de un modelo?
Sí la plataforma permite ejecutar experimentos en paralelo para comparar métricas de rendimiento y determinar exactamente qué cambios mejoran o empeoran el resultado.
Precio de Confident AI y planes disponibles
Free
0 $ al mes
Suite completa de pruebas unitarias y de regresión para LLM.
Evaluaciones en desarrollo y CI/CD.
Trazado de LLM (LLM tracing).
Versionado de prompts.
Conjuntos de datos (datasets) en la nube.
Soporte de comunidad y documentación.
Límites: Restringido a 2 usuarios, 1 proyecto, 5 ejecuciones de prueba por semana y 1 GB al mes de almacenamiento de trazas.
Starter
200 $ al mes
Incluye todo lo del plan Free.
Flujos de trabajo de evaluación de IA sin código.
Métricas de evaluación personalizadas.
Evaluaciones online y clasificaciones en tráfico real.
Flujos y colas de anotación.
Simulaciones de chat.
Flujos de observabilidad downstream y alertas en tiempo real.
Acceso completo a la API del proyecto.
Límites: Usuarios ilimitados, máximo 5 proyectos y 5 GB al mes de trazas (luego 1 $ por GB adicional).
Team
2.000 $ al mes
Incluye todo lo del plan Starter.
Versionado de métricas y datasets.
Flujos de trabajo de prompts basados en Git.
Control de acceso basado en roles (RBAC) personalizado.
Certificación SOC2 y acceso mediante SSO.
Canal de soporte dedicado.
Límites: Usuarios y proyectos ilimitados, 75 GB al mes de trazas (luego 1 $ por GB adicional).
Enterprise
Precio personalizado (consultar con la web oficial)
Incluye todo lo del plan Team.
Opciones avanzadas de autenticación de IA.
API de gestión de la organización.
Despliegue local dedicado (On-Prem).
Revisión de seguridad de la información (Infosec).
Residencia de datos personalizada y cumplimiento HIPAA.
Soporte técnico dedicado 24/7.
Módulos avanzados de Red Teaming y Gobernanza de IA.
Límites: Sin restricciones en usuarios, proyectos, volumen de trazas o ejecuciones de métricas online.
Capturas de pantalla de Confident AI
Alternativas a Confident AI
Vals Smith
Transforma repositorios de GitHub en bancos de pruebas personalizados para evaluar y comparar el rendimiento de modelos de IA y agentes de programación sobre tu propio código.