GMI Cloud
Compartir
Infraestructura en la nube para computación e inferencia de IA. Proporciona clústeres de GPU NVIDIA y escalado automático para desplegar modelos y agentes en producción.
Qué es GMI Cloud y para qué sirve
GMI Cloud es una plataforma de infraestructura de IA diseñada específicamente para el despliegue, la inferencia y la gestión de agentes en entornos de producción. Como socio preferente de NVIDIA, esta solución unifica en una sola nube el acceso a clústeres de GPU de alto rendimiento y tiempos de ejecución optimizados, permitiendo a empresas y desarrolladores gestionar cargas de trabajo de inteligencia artificial a escala sin las complicaciones de la arquitectura tradicional.
La herramienta funciona bajo un enfoque de inferencia serverless por defecto, lo que permite ejecutar modelos de IA de forma instantánea. Su tecnología permite un escalado automático a cero, eliminando costes por inactividad y optimizando el uso de recursos mediante el procesamiento por lotes integrado y una programación consciente de la latencia. Para proyectos que requieren un control total, GMI Cloud facilita la transición hacia una infraestructura de GPU dedicada mediante servidores bare metal basados en la arquitectura de nube de referencia de NVIDIA, utilizando hardware avanzado como las unidades NVIDIA H100, H200 y Blackwell.
Entre sus capacidades principales y beneficios funcionales destacan:
- API unificada: Acceso simplificado a una biblioteca de modelos de lenguaje extenso (LLM) y modelos multimodales, incluyendo opciones como DeepSeek, MiniMax y Gemini.
- Rendimiento optimizado: Capacidad para lograr una inferencia hasta 5 veces más rápida y un rendimiento de procesamiento (throughput) significativamente superior al de nubes de propósito general.
- Redes preparadas para RDMA: Garantiza una latencia mínima y un rendimiento estable en clústeres de múltiples nodos, ideal para el entrenamiento y la inferencia a gran escala.
- Flexibilidad de configuración: Permite desde el uso de endpoints serverless hasta el acceso de raíz (root access) y pilas personalizadas en clústeres dedicados.
- Aislamiento multi-inquilino: Asegura que el rendimiento sea predecible y seguro, evitando interferencias entre diferentes cargas de trabajo en el mismo ordenador o servidor físico.
GMI Cloud está dirigida a equipos de desarrollo y empresas que necesitan trasladar prototipos de IA a entornos de producción reales. Es especialmente valiosa para aplicaciones de generación de vídeo en tiempo real, sistemas de audio y clonación de voz, así como para el desarrollo de modelos fundacionales que exigen una baja latencia de inferencia y una alta resiliencia. Al centralizar la computación y la orquestación en una plataforma optimizada, los usuarios pueden escalar sus operaciones de inteligencia artificial generativa de manera eficiente, reduciendo los costes operativos y acelerando los ciclos de iteración tecnológica.
Funciones y casos de uso de GMI Cloud
Cómo usar GMI Cloud
Preguntas frecuentes sobre GMI Cloud
¿Qué es GMI Cloud y qué servicios ofrece?
Es una plataforma de infraestructura de IA unificada que proporciona soluciones de computación, inferencia y agentes optimizados para escalar proyectos de inteligencia artificial en producción.
¿Qué modelos de GPU están disponibles en GMI Cloud?
Actualmente ofrecemos acceso a GPUs NVIDIA H100 y H200 para su uso inmediato, además de la posibilidad de realizar reservas para la próxima plataforma NVIDIA Blackwell.
¿Cuál es el coste de uso de las GPUs por hora?
La tarifa para la NVIDIA H100 es de 2,00 dólares por hora de uso, mientras que el modelo NVIDIA H200 tiene un precio de 2,60 dólares por hora.
¿Cómo gestiona GMI Cloud el escalado de la inferencia?
La inferencia es sin servidor por defecto y permite un escalado automático a cero cuando no hay actividad, lo que elimina costes innecesarios por tiempo de inactividad.
¿Qué tipos de modelos de IA se pueden ejecutar en la plataforma?
Es posible ejecutar modelos de lenguaje de gran tamaño, sistemas de generación de imágenes, vídeo, audio y cualquier carga de trabajo multimodal a través de una API unificada.
¿Qué ventajas de rendimiento ofrece GMI Cloud frente a otros proveedores?
Nuestra infraestructura logra una inferencia cinco veces más rápida y un escalado ante picos de demanda el doble de veloz, reduciendo los costes operativos en un treinta por ciento.
¿Ofrece GMI Cloud opciones de infraestructura dedicada?
Sí, disponemos de servidores de metal desnudo con acceso root y clústeres de GPUs dedicadas para cargas de trabajo que requieren un control total y un rendimiento predecible.
¿Qué modelos específicos se pueden encontrar en la biblioteca de GMI Cloud?
Contamos con acceso a modelos destacados como MiniMax-M3, DeepSeek-V4, Gemini-3.6-Flash y diversas herramientas de clonación de voz y generación de imágenes.
¿Es GMI Cloud un socio oficial de NVIDIA?
Sí, somos un socio preferente de NVIDIA y nuestra arquitectura de nube está validada según sus diseños de referencia para garantizar la máxima fiabilidad y escala.
Precio de GMI Cloud y planes disponibles
Inferencia Serverless (Sin servidor): Precio según uso del modelo sin costes por inactividad.
Escalado automático a cero cuando no hay carga.
Procesamiento por lotes (batching) integrado.
Programación de tareas optimizada para la latencia.
Aislamiento multi-inquilino para garantizar un rendimiento predecible.
Acceso a APIs de modelos LLM y multimodales listas para producción.
NVIDIA H100: 2,00 $/hora por GPU.
Infraestructura de GPU dedicada (bare metal).
Ideal para tareas de inferencia y entrenamiento que requieren gran ancho de banda de memoria.
Soporte para modelos de gran tamaño.
Acceso root y pilas personalizadas.
NVIDIA H200: 2,60 $/hora por GPU.
Optimizado para entrenamiento e inferencia a gran escala.
Alto rendimiento y disponibilidad garantizada.
Orquestación de clústeres multinodo a nivel de infraestructura.
NVIDIA Blackwell: Consultar disponibilidad para reserva (Pre-order).
Diseñado para despliegues masivos que requieren el máximo rendimiento disponible.
Próximamente disponible en la plataforma.
Biblioteca de Modelos (API): Precios variables por millón de tokens o por solicitud.
MiniMax-M3: 0,24 $/M tokens de entrada y 0,96 $/M tokens de salida.
DeepSeek-V4-Flash-0731: 0,286 $/M tokens de entrada y 0,858 $/M tokens de salida.
Gpt-6.1-Sol: 2,00 $/M tokens de entrada y 10,00 $/M tokens de salida.
Gemini-3.6-Flash: 1,50 $/M tokens de entrada y 7,50 $/M tokens de salida.
Modelos de Audio (Minimax): Entre 0,06 $ y 0,15 $ por solicitud según la versión (Turbo/HD).
Modelos de Imagen (Hunyuan/Hy-Image): Entre 0,024 $ y 0,08 $ por solicitud.
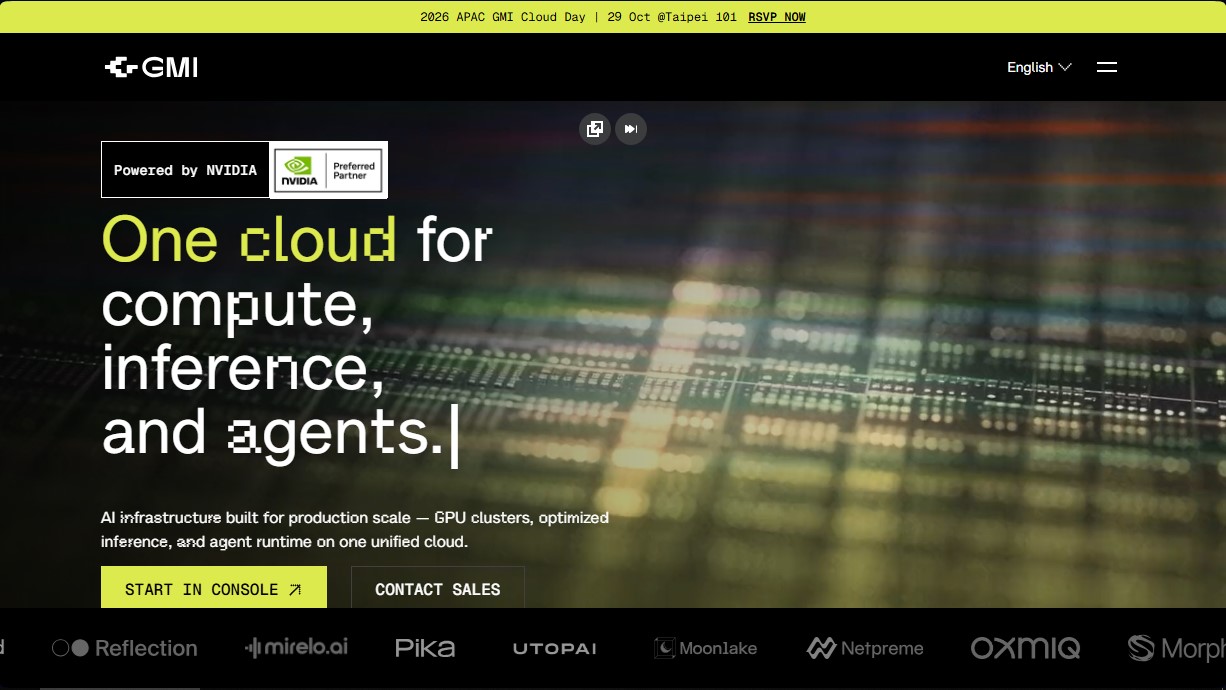
Capturas de pantalla de GMI Cloud
Alternativas a GMI Cloud
Nuclr Commander
Espacio de trabajo para ejecutar varios agentes de IA en paralelo con gestor de archivos. Soporta modelos locales o externos y supervisión remota desde el móvil.
SpeakCrate
API de código abierto para síntesis de voz local y privada. Permite generar audio multilingüe en servidores propios y es compatible con el estándar de OpenAI.
Agent-Native
Agent-Native es un framework de código abierto en TypeScript para crear agentes de IA con interfaz propia: agente y UI comparten acciones, datos y estado.