Inference
Compartir
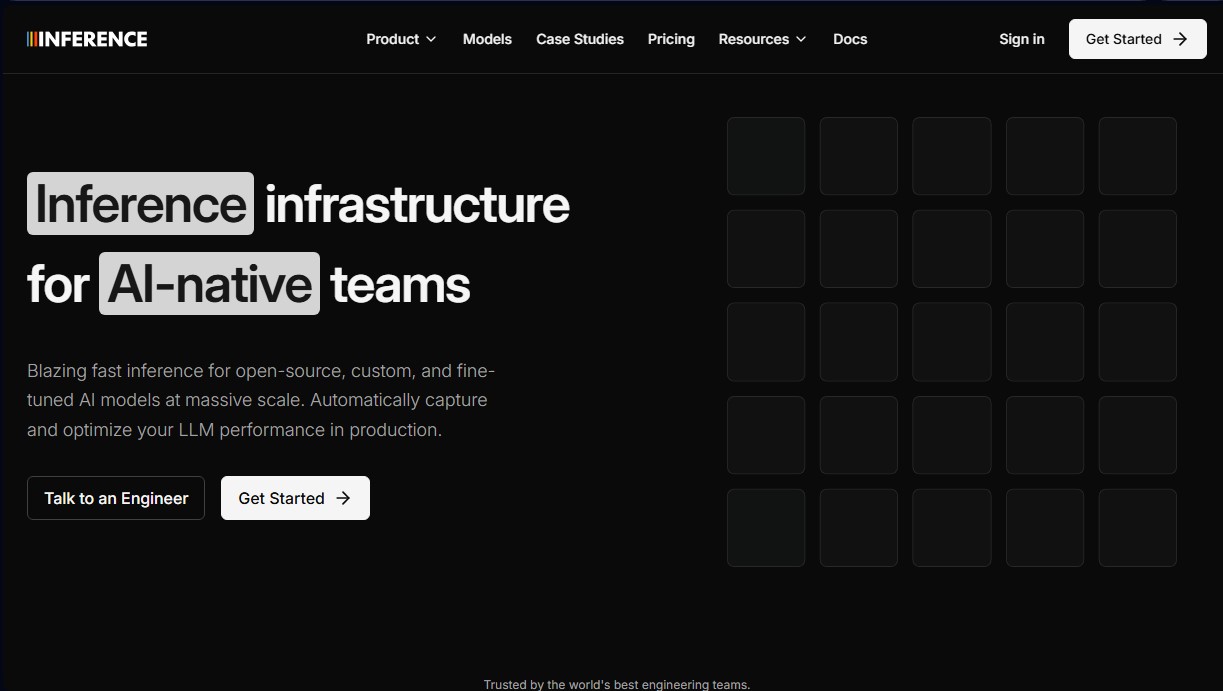
Infraestructura para desplegar, monitorizar y entrenar modelos de IA. Optimiza el rendimiento de LLM en producción con herramientas de evaluación y observabilidad en tiempo real.
Qué es Inference y para qué sirve
Inference es una plataforma de infraestructura avanzada diseñada específicamente para equipos de ingeniería que desarrollan aplicaciones nativas de inteligencia artificial. Su función principal es facilitar el despliegue, la monitorización y el entrenamiento de modelos de lenguaje de gran tamaño (LLM) de código abierto, personalizados o ajustados para funcionar a gran escala. Esta herramienta permite a las organizaciones migrar desde proveedores cerrados hacia una infraestructura optimizada que reduce drásticamente la latencia y los costes operativos sin sacrificar la calidad.
La capacidad de despliegue de modelos es uno de sus pilares fundamentales. Inference ofrece un entorno de alojamiento de alto rendimiento que permite ejecutar modelos como GLM-5, MiniMax o GPT-OSS en infraestructuras de nube pública, privada o híbrida. Gracias a su arquitectura técnica, los equipos pueden alcanzar una disponibilidad del 99,99% y reducir significativamente el tiempo de respuesta en producción, permitiendo que cualquier ordenador o servidor que procese las solicitudes mantenga una velocidad de inferencia constante y fiable.
Para asegurar un funcionamiento óptimo, la herramienta integra un sistema de observabilidad de LLM de grado de producción. Esta funcionalidad permite rastrear cada solicitud, analizando prompts, llamadas a herramientas y respuestas en tiempo real. Los desarrolladores pueden monitorizar métricas críticas como la latencia p90, el uso de tokens y las tasas de error. Entre sus capacidades principales destacan:
- Monitorización de producción: Rastreo detallado de cada ruta de solicitud para identificar comportamientos de proveedores y patrones de uso.
- Fine-tuning automatizado: Flujos de trabajo para el ajuste fino de modelos personalizados en pocos minutos, adaptándolos a tareas específicas del dominio.
- Evaluación continua: Comparación de variantes de modelos contra trazas de producción reales para detectar regresiones antes del despliegue.
- Curación de datos: Transformación de trazas de producción en conjuntos de datos de entrenamiento de alta señal de forma automática.
Inference destaca por su enfoque en el volante de datos privado (data flywheel), permitiendo que el modelo mejore en cada ciclo al aprender de los datos generados por el usuario final. Esto es especialmente útil para aplicaciones de extracción de datos, clasificación y agentes de IA que requieren una precisión superior a la de los modelos genéricos.
La seguridad es otro aspecto clave, ya que la plataforma cuenta con la certificación SOC 2 Type II, garantizando un control total y supervisión operativa sobre toda la pila tecnológica. Esto la convierte en una solución robusta para empresas que necesitan escalar su infraestructura de inferencia manteniendo la privacidad y la soberanía de sus datos. Con un enfoque en la eficiencia, ayuda a los equipos de producto a obtener un rendimiento de nivel frontera con un menor consumo de computación.
Funciones y casos de uso de Inference
Cómo usar Inference
Preguntas frecuentes sobre Inference
¿Qué es exactamente la plataforma Inference y para qué sirve?
Es una infraestructura de inferencia diseñada para equipos centrados en inteligencia artificial que permite desplegar, monitorizar y entrenar modelos de código abierto a gran escala con un rendimiento optimizado.
¿Puedo migrar mis cargas de trabajo desde OpenAI o Anthropic a Inference?
Sí, la herramienta permite cambiar fácilmente de proveedores propietarios a modelos de código abierto ejecutados en una infraestructura optimizada específicamente para cada carga de trabajo.
¿Cómo ayuda la función AutoEvals de Inference a encontrar el modelo adecuado?
Esta función permite evaluar continuamente los modelos comparándolos con trazas de producción reales para medir la calidad, el coste y la latencia antes del despliegue final.
¿Qué garantías de disponibilidad ofrece Inference para el despliegue de modelos?
La plataforma garantiza un tiempo de actividad del noventa y nueve coma noventa y nueve por ciento para asegurar que los modelos estén siempre operativos en entornos de producción críticos.
¿Es posible realizar un ajuste fino de modelos personalizados en Inference?
Sí, puedes realizar el entrenamiento de modelos de lenguaje de nivel de frontera en pocos minutos utilizando flujos de trabajo automáticos basados en tus propios datos de producción.
¿Cumple la herramienta Inference con los estándares de seguridad para el manejo de datos?
La plataforma cuenta con la certificación SOC dos Tipo dos lo que asegura un control total y una supervisión operativa estricta sobre los datos y modelos en toda la infraestructura.
¿Qué planes de precios ofrece Inference para los nuevos usuarios?
Existe un plan gratuito de pago por uso para comenzar, un plan Growth de doscientos cincuenta dólares al mes para equipos con cargas de producción y opciones personalizadas para empresas.
¿Qué tipo de observabilidad proporciona Inference sobre los modelos desplegados?
La herramienta permite rastrear cada solicitud para ver prompts y respuestas además de monitorizar la latencia y los patrones de uso a medida que escala el tráfico.
Precio de Inference y planes disponibles
Pay as you go
0 $ + uso
1 millón de peticiones Gateway incluidas.
1 millón de "tracing spans" al mes.
Retención de datos de 14 días.
1 acceso (seat).
Límite de velocidad de 30 req/min.
Growth
250 $ al mes
50 $ de crédito de apertura único.
50 millones de peticiones Gateway al mes.
50 millones de "tracing spans" al mes.
Retención de datos ilimitada.
Usuarios (seats) ilimitados.
Límite de velocidad de 250 req/min.
Enterprise
Consultar con el equipo de ventas
Contratos personalizados y precios por uso comprometido.
Infraestructura dedicada y límites de despliegue a medida.
Canal de soporte directo con el equipo técnico.
Modelos personalizados entrenados para cargas de trabajo específicas.
Aparte de los planes de suscripción, el despliegue de modelos en instancias B200 (como Kimi K2.5, MiniMax-M2.5, GLM-5 o GPT-OSS 120B) tiene un coste de 9,98 $ por hora.
Capturas de pantalla de Inference
Alternativas a Inference
Nuclr Commander
Espacio de trabajo para ejecutar varios agentes de IA en paralelo con gestor de archivos. Soporta modelos locales o externos y supervisión remota desde el móvil.
SpeakCrate
API de código abierto para síntesis de voz local y privada. Permite generar audio multilingüe en servidores propios y es compatible con el estándar de OpenAI.
Agent-Native
Agent-Native es un framework de código abierto en TypeScript para crear agentes de IA con interfaz propia: agente y UI comparten acciones, datos y estado.