Liquid Inference
Compartir
Qué es Liquid Inference y para qué sirve
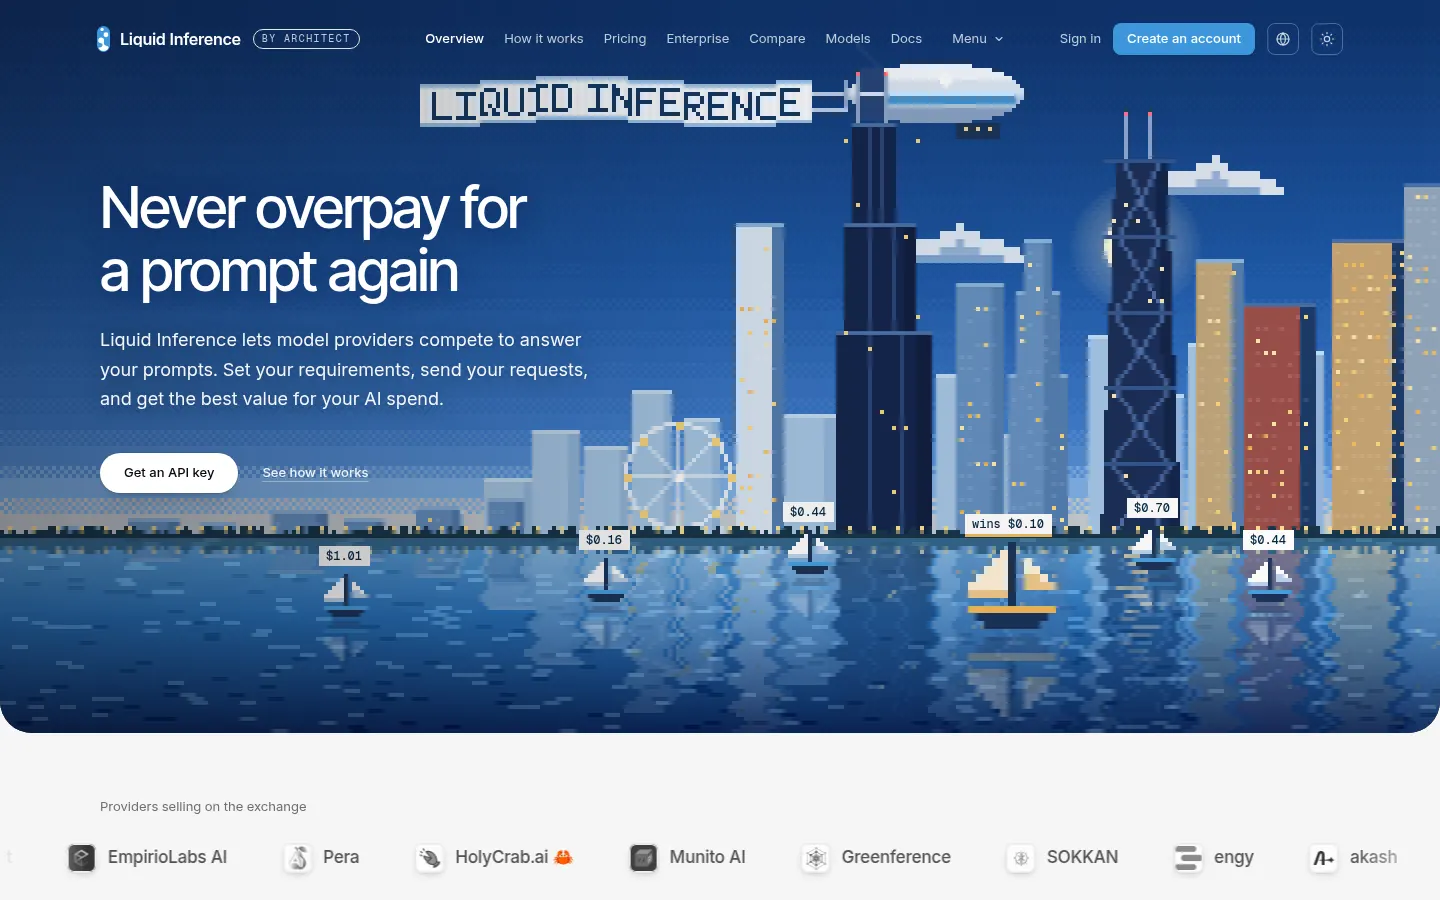
Liquid Inference es una herramienta de IA que funciona como mercado de subastas para inferencia de LLM. Los proveedores de modelos compiten por responder cada una de tus peticiones: tú fijas los requisitos, envías la solicitud y la mejor puja se queda el trabajo, para que tu gasto en IA rinda lo máximo posible.
¿Qué es Liquid Inference y para qué sirve?
Sirve para pagar menos por cada prompt sin cambiar tu código. Cada proveedor publica lo que cobra por token para los modelos que sirve, y en cada petición se celebra una subasta instantánea. El importe ganador queda limitado antes de que el modelo empiece a generar, así que un trabajo nunca supera ese tope y lo no usado vuelve a tu saldo. Las pujas varían con la demanda y la capacidad: los proveedores bajan cuando tienen capacidad libre.
¿Cómo funciona Liquid Inference?
Basta con cambiar dos cosas en código compatible con la API de OpenAI o Anthropic: la URL base y la clave. Funciona con clientes y herramientas de programación con IA que hablan esas API, como GitHub Copilot CLI. Puedes filtrar solo proveedores sin retención de datos, ver benchmarks independientes y el historial público de pujas, y elegir el mejor modelo para tu tope. El Auto Router elige modelo por puntuación publicada dentro de un límite, y las reservas dan un bloque mensual de tokens de un proveedor.
¿Para quién es Liquid Inference?
- Desarrolladores que llaman a LLM desde sus aplicaciones o agentes.
- Equipos con mucho volumen que quieren reducir su gasto en IA.
- Usuarios de agentes de programación con modelos abiertos.
- Proveedores con capacidad de GPU que quieren vender inferencia.
Ventajas y limitaciones de Liquid Inference
Ofrece transparencia: cada trabajo tiene un recibo con la puja ganadora y lo consumido, el servicio no guarda el texto de peticiones ni respuestas, y si un proveedor falla antes de responder se prueba la siguiente puja. Además dispone de CLI y servidor MCP. Como limitación, solo admite los nombres de modelo que lista el mercado y la calidad puede variar entre proveedores.
Funciones y casos de uso de Liquid Inference
Cómo usar Liquid Inference
Preguntas frecuentes sobre Liquid Inference
¿Qué es Liquid Inference?
Liquid Inference es un mercado donde los proveedores de modelos de IA compiten en una subasta por responder cada petición al mejor precio.
¿Liquid Inference es gratis?
No, se paga por uso más una comisión del mercado, aunque los espacios nuevos reciben saldo inicial sin tarjeta; los detalles están en la sección de precios.
¿Qué tengo que cambiar en mi código?
En la mayoría de código para OpenAI o Anthropic, la URL base y la clave de API, usando nombres de modelo que liste el mercado.
¿Puede una petición costar más de lo previsto?
No, se fija un tope antes del primer token y el trabajo nunca lo supera.
¿Guarda mis prompts?
No guarda el texto de peticiones ni respuestas, salvo prompts que guardes en un workload; puedes limitarte a proveedores sin retención.
¿Qué pasa si un proveedor falla?
Si falla antes de generar, el mercado prueba la siguiente oferta; una vez empieza la respuesta no cambia de proveedor.
¿Liquid Inference tiene API?
Sí, es una API compatible con OpenAI y Anthropic, y además ofrece CLI y servidor MCP.
¿Liquid Inference funciona en español?
La web está en inglés; los modelos que sirve pueden recibir y responder prompts en español según cada modelo.
¿Puedo vender inferencia en Liquid Inference?
Sí, los proveedores registran sus despliegues, fijan su tarifa y cobran por los tokens que sirven.
¿Qué alternativas hay a Liquid Inference?
En el directorio puedes compararlo con OpenRouter, que da acceso unificado a muchos modelos, o con Groq para inferencia rápida de modelos abiertos.
Precio de Liquid Inference y planes disponibles
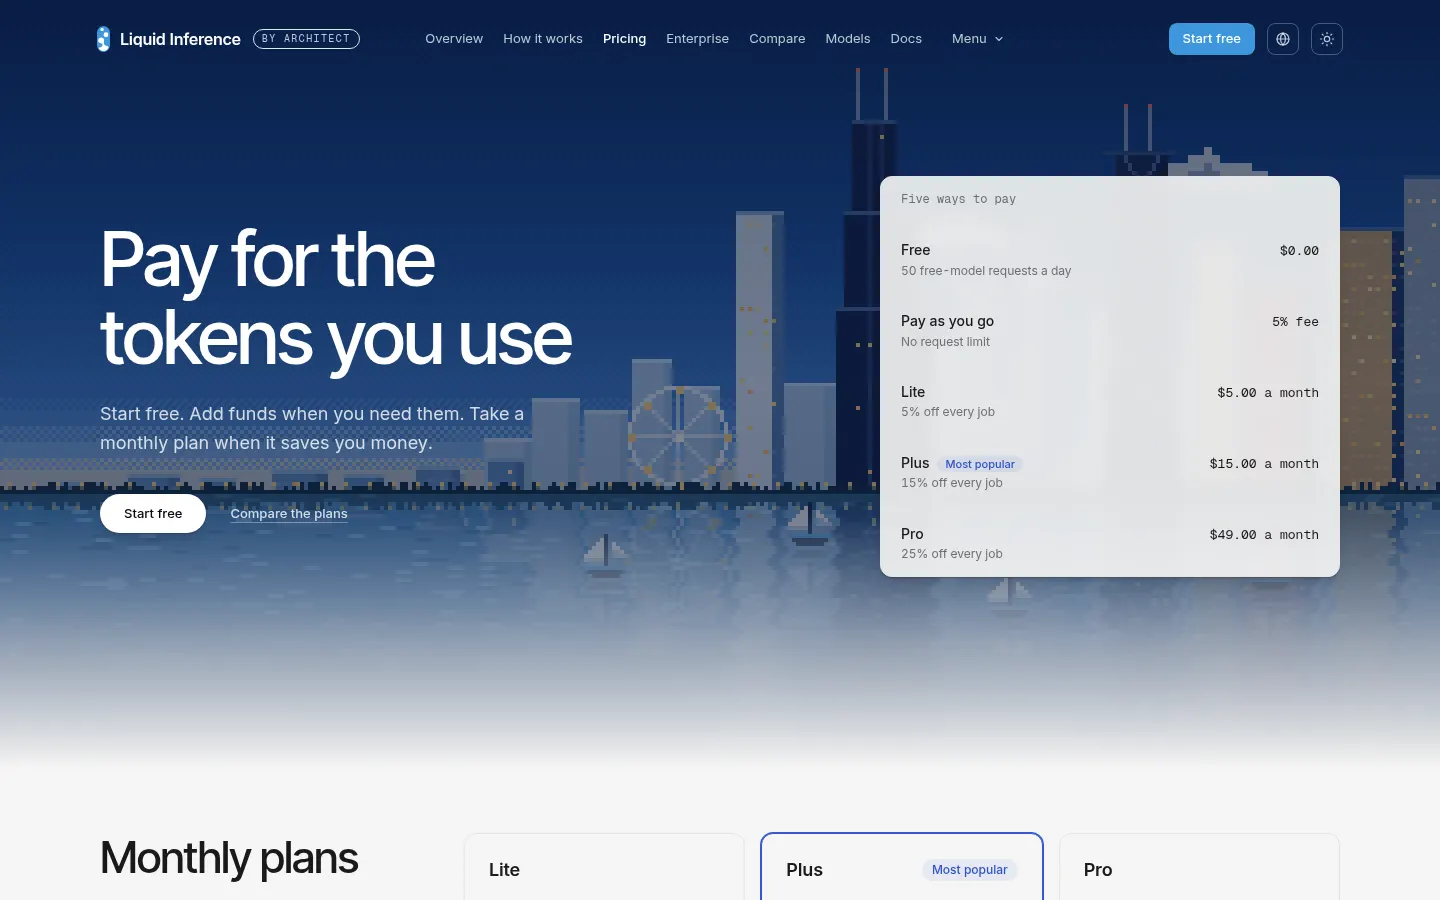
Precios en dólares (USD) de la web oficial, pago por uso. Consulta: 17/11/2026.
Pagas los tokens de cada trabajo al precio del proveedor que gana la subasta (varía por modelo y por minuto) más la comisión del mercado: el mayor entre el 5 % del cargo del proveedor y un mínimo de 1 céntimo por millón de tokens. Un trabajo que falla antes de generar no paga comisión.
- Los espacios nuevos reciben saldo inicial para probar sin tarjeta.
- Reservas: bloque mensual de tokens de un proveedor con cuota fija según presupuesto.
- Los proveedores no pagan cuota de alta ni de transacción.
Capturas de pantalla de Liquid Inference
Opiniones de usuarios sobre Liquid Inference
Escribir una reseña
Comprobando sesión...
Reseñas de Liquid Inference
Cargando reseñas...