General Compute
Compartir
Infraestructura de inferencia para modelos de IA mediante chips ASIC. Es siete veces más rápida que las GPU convencionales y totalmente compatible con la API de OpenAI.
Qué es General Compute y para qué sirve
General Compute se define como una infraestructura de inferencia de inteligencia artificial de alto rendimiento, diseñada específicamente para optimizar la ejecución de modelos de lenguaje de gran tamaño (LLM). A diferencia de los proveedores tradicionales que utilizan unidades de procesamiento gráfico (GPU) adaptadas, esta plataforma emplea aceleradores de IA personalizados (ASIC) creados desde cero exclusivamente para la inferencia. Este enfoque técnico permite eliminar el lastre de las arquitecturas heredadas de procesamiento de imagen, ofreciendo una solución mucho más eficiente y veloz para desarrolladores y empresas que requieren despliegues de IA en producción.
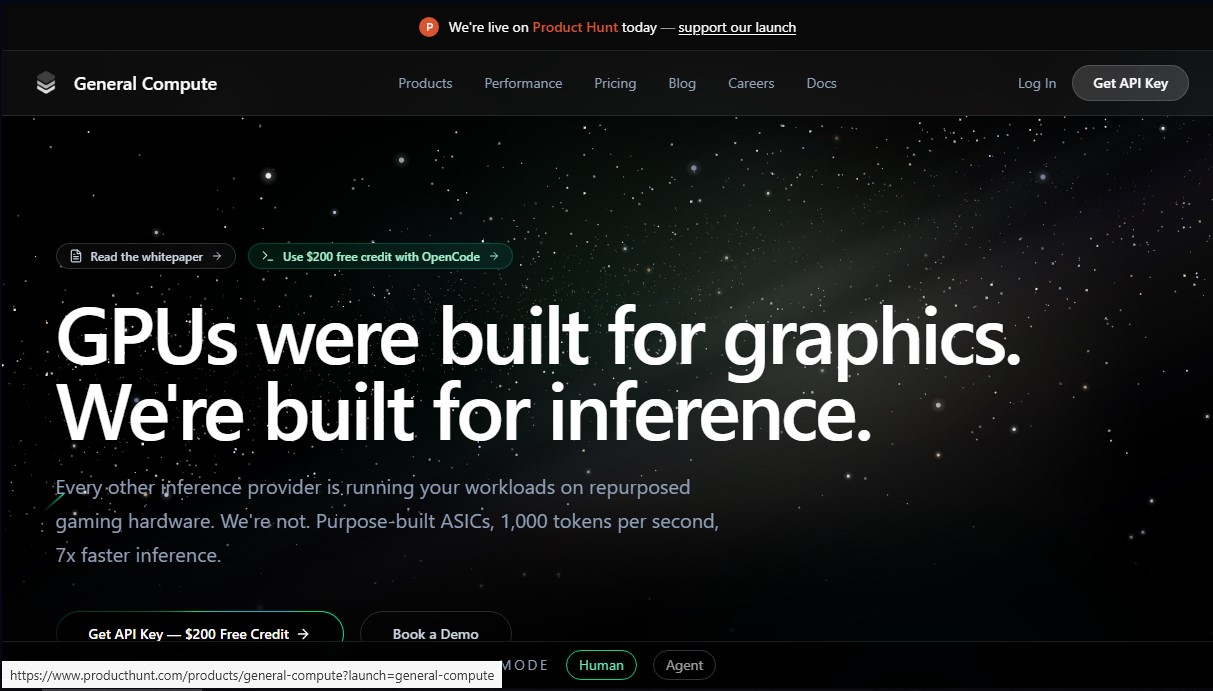
El funcionamiento de General Compute se basa en una arquitectura de hardware optimizada que logra una velocidad de inferencia hasta 7 veces superior a la de las infraestructuras basadas en la nube de GPU convencionales. Gracias a sus chips especializados, la herramienta es capaz de alcanzar tasas de procesamiento de más de 1.000 tokens por segundo, con un tiempo hasta el primer token (TTFT) inferior a los 300 milisegundos. Esta capacidad de respuesta es crítica para aplicaciones en tiempo real, como agentes de programación o sistemas de atención al cliente automatizados que funcionan en un ordenador o servidor remoto.
La integración para los desarrolladores es directa y simplificada mediante una API compatible con OpenAI. Esto permite migrar cargas de trabajo existentes simplemente cambiando la URL base y la clave de API en el código, sin necesidad de reescribir la lógica de la aplicación. Además, la plataforma ofrece soporte para SDKs, webhooks y MCP, facilitando la conexión con herramientas como OpenClaw, un agente de codificación que puede autoconfigurarse para utilizar esta infraestructura y mejorar su rendimiento de forma inmediata.
Entre las capacidades funcionales de General Compute destacan:
- Despliegue de modelos personalizados: Permite ejecutar pesos propios (BYOM) sobre su infraestructura optimizada, manteniendo la misma velocidad que los modelos preconfigurados.
- Escalabilidad bajo demanda: Ofrece desde una API de autoservicio para prototipado rápido hasta capacidad dedicada con acuerdos de nivel de servicio (SLA) del 99,9% para entornos de producción masiva.
- Eficiencia energética superior: Sus racks consumen solo 17 kW frente a los 120 kW de las soluciones GPU equivalentes, lo que optimiza el uso de recursos.
- Infraestructura refrigerada por aire: Elimina la complejidad y los costes derivados de la refrigeración líquida, garantizando un entorno operativo estable.
Esta herramienta es ideal para ingenieros de software y arquitectos de soluciones que buscan reducir la latencia en inferencia de IA y optimizar el rendimiento de sus modelos sin las limitaciones del hardware gráfico tradicional. Al centrarse únicamente en la fase de ejecución y no en el entrenamiento, General Compute proporciona un entorno especializado donde la velocidad y la estabilidad son las prioridades principales para el desarrollo de aplicaciones de IA modernas.
Funciones y casos de uso de General Compute
Cómo usar General Compute
Preguntas frecuentes sobre General Compute
¿Qué diferencia a General Compute de otros proveedores de inferencia basados en GPU?
A diferencia de los proveedores que reutilizan hardware de videojuegos, General Compute utiliza aceleradores ASIC diseñados exclusivamente para la inferencia, logrando una velocidad siete veces superior.
¿Cómo puedo integrar General Compute en mi aplicación si ya uso OpenAI?
Nuestra API es totalmente compatible con OpenAI, por lo que solo necesitas cambiar la URL base y tu clave de API en el código existente para empezar a funcionar en treinta segundos.
¿Qué ventajas de rendimiento ofrece la infraestructura de General Compute?
Nuestra plataforma permite alcanzar más de mil tokens por segundo y un tiempo de respuesta hasta el primer token inferior a trescientos milisegundos.
¿Existe alguna prueba gratuita para probar General Compute?
Sí, ofrecemos doscientos dólares de crédito gratuito para nuevos usuarios al registrarse, permitiendo probar el rendimiento de los modelos sin coste inicial.
¿Es posible utilizar modelos personalizados o pesos privados en vuestro hardware?
Sí, permitimos el despliegue de modelos propios y pesos privados sobre nuestra infraestructura optimizada, manteniendo la misma velocidad que en nuestros modelos estándar.
¿Qué es OpenClaw y cómo facilita el trabajo con General Compute?
OpenClaw es un agente de programación que puede configurarse automáticamente para obtener una clave de API y cambiar el proveedor de inferencia de forma sencilla.
¿Por qué el consumo energético de General Compute es menor que el de las nubes de GPU tradicionales?
Gracias al uso de hardware especializado y refrigeración por aire, consumimos diecisiete kilovatios por rack frente a los ciento veinte de las GPU, lo que reduce drásticamente los costes operativos.
¿Qué tipos de planes de precios ofrece la herramienta?
Disponemos de un modelo de pago por uso mediante nuestra API de autoservicio y opciones de capacidad dedicada con acuerdos de nivel de servicio para entornos de producción a gran escala.
Precio de General Compute y planes disponibles
Self-serve API: 200 $ de crédito gratuito para nuevas cuentas. Una vez agotado el crédito, el modelo de precios se basa en el pago por uso.
Acceso inmediato a una API compatible con OpenAI.
Inferencia de alta velocidad mediante aceleradores ASICs (hasta 1.000 tokens por segundo).
Tiempo de respuesta para el primer token (TTFT) inferior a 300 ms.
Uso de infraestructura optimizada con bajo consumo energético.
Dedicated capacity: Precio personalizado (consultar con el equipo de ventas).
Reserva de infraestructura dedicada para cargas de trabajo en producción.
Capacidad garantizada y escalado personalizado.
SLA de disponibilidad del 99,9 %.
Soporte directo para necesidades de gran volumen.
Bring your model: Precio personalizado (consultar con el equipo de ventas).
Despliegue de modelos y pesos privados en infraestructura optimizada.
Capa de servicio ajustada específicamente a la carga de trabajo del cliente.
Mantenimiento de la misma velocidad de inferencia que los modelos estándar del sistema.
Capturas de pantalla de General Compute
Opiniones de usuarios sobre General Compute
Escribir una reseña
Comprobando sesión...
Reseñas de General Compute
Cargando reseñas...
Alternativas a General Compute
Together Link
Conecta agentes de programación con modelos abiertos para reducir costes. Mantén tus herramientas y ajustes habituales mientras optimizas el consumo de tokens en cada sesión.
Optimus by Iacon Autonomics
Investigador autónomo que diseña experimentos y evalúa algoritmos para entrenar modelos de IA. Automatiza el ciclo de mejora en LLM, robótica y diversos sistemas complejos.
Nuclr Commander
Espacio de trabajo para ejecutar varios agentes de IA en paralelo con gestor de archivos. Soporta modelos locales o externos y supervisión remota desde el móvil.