Compartir
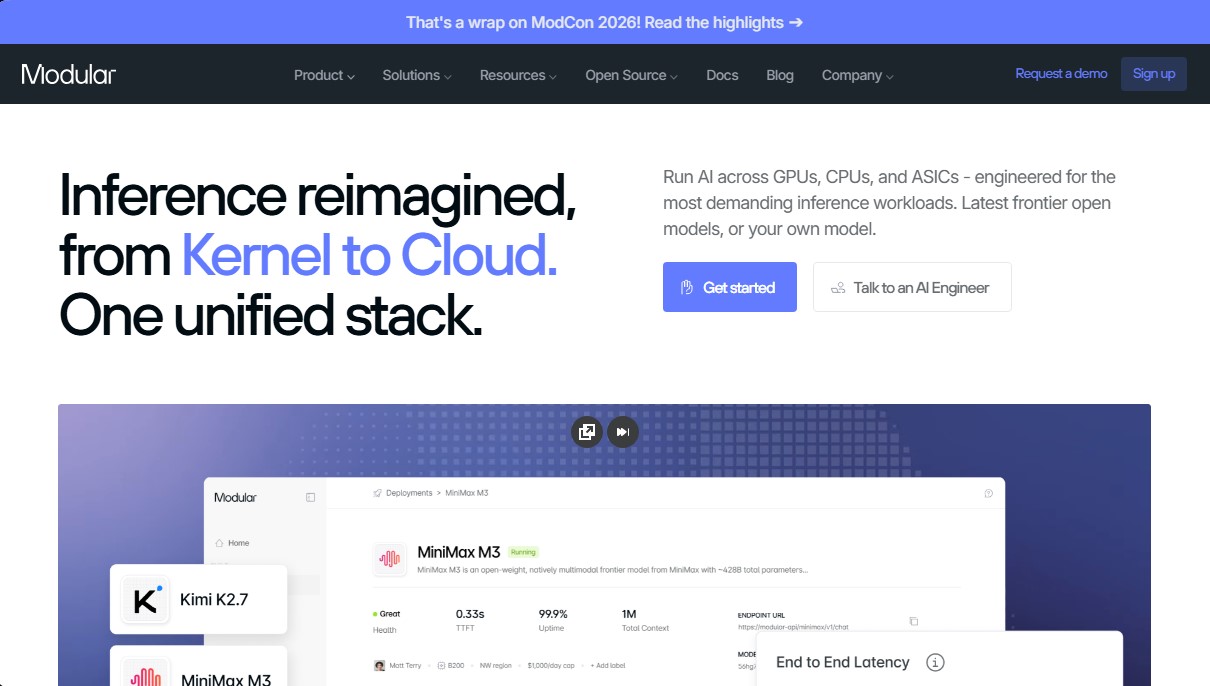
Plataforma de inferencia unificada para optimizar y ejecutar modelos de IA en GPUs, CPUs y ASICs. Maximiza el rendimiento y reduce costes con total portabilidad de hardware.
Qué es Modular y para qué sirve
Modular es una plataforma unificada de inferencia de IA diseñada para optimizar el rendimiento y la portabilidad de los modelos en diversos entornos de computación. Esta solución integra una pila tecnológica completa que abarca desde el kernel hasta el punto final de la API, permitiendo ejecutar cargas de trabajo de inteligencia artificial de alta demanda de forma eficiente. Su objetivo principal es eliminar la fragmentación en la infraestructura de IA, ofreciendo un sistema coherente que funciona tanto en centros de datos como en dispositivos locales u ordenadores personales.
La arquitectura de la herramienta se basa en dos pilares fundamentales: el motor de inferencia MAX y el lenguaje de programación Mojo. Mojo se presenta como una evolución de Python orientada al alto rendimiento, permitiendo escribir código sencillo que se compila para aprovechar al máximo los aceleradores modernos. Por su parte, la tecnología de compilador de Modular genera automáticamente kernels optimizados para diferentes arquitecturas de hardware, lo que garantiza una independencia del proveedor (vendor independence) real y evita el bloqueo con un único fabricante de chips.
Una de las mayores ventajas de Modular es su capacidad para ejecutar el mismo código y modelo en una amplia variedad de procesadores sin necesidad de reescrituras costosas. El sistema soporta más de 15 arquitecturas de GPU, CPU y ASIC, incluyendo:
- NVIDIA y AMD (como la serie MI355X).
- Apple Silicon (chips M1, M2 y M3) y arquitecturas ARM.
- Hardware especializado como AWS Trainium, Google TPU y soluciones de Qualcomm.
- Procesadores Intel y arquitecturas x86 estándar.
La plataforma ofrece flexibilidad en el despliegue para adaptarse a las necesidades de seguridad y escalabilidad de cada equipo técnico. Modular Cloud proporciona puntos finales gestionados (compartidos o dedicados) con baja latencia, mientras que la opción Your Cloud (BYOC) permite la ejecución dentro de la propia VPC del cliente para mantener la privacidad de los datos. También existe una versión Self-Hosted mediante contenedores para un control total de la infraestructura.
En términos prácticos, Modular destaca por reducir significativamente el Time to First Token (TTFT), situándolo por debajo de los 500ms en aplicaciones conversacionales. Es una herramienta esencial para ingenieros de IA y empresas que buscan implementar:
- Agentes de IA y copilotos de programación con capacidad de respuesta instantánea.
- Modelos de generación de imágenes y flujos de trabajo visuales de alta velocidad.
- Sistemas de texto a audio con síntesis de voz natural en tiempo real.
- Despliegue de modelos de lenguaje de gran escala (LLM) como DeepSeek R1, Llama o MiniMax M3.
Gracias a su enfoque en la optimización de la pila completa, la herramienta permite obtener hasta un 2x de rendimiento adicional y ahorros considerables en costes operativos al maximizar la utilización del hardware disponible. Es una solución robusta para quienes necesitan escalar aplicaciones de IA desde la fase de prototipo hasta la producción masiva sin sacrificar el control técnico.
Funciones y casos de uso de Modular
Cómo usar Modular
Preguntas frecuentes sobre Modular
¿Qué es exactamente la plataforma Modular?
Modular es una infraestructura unificada de inferencia de IA que permite ejecutar modelos en diversas arquitecturas de hardware con un rendimiento optimizado.
¿En qué tipo de hardware puedo ejecutar mis modelos con Modular?
La plataforma es compatible con una amplia gama de procesadores incluyendo GPUs de NVIDIA y AMD, así como CPUs y ASICs de Qualcomm, Apple, Intel y AWS.
¿Qué ventajas ofrece el lenguaje Mojo dentro del ecosistema de Modular?
Mojo es un lenguaje diseñado para el desarrollo de IA que combina la sintaxis de Python con el rendimiento de C, permitiendo escribir kernels personalizados de alta velocidad.
¿Cuáles son las opciones de despliegue disponibles en Modular?
Puedes elegir entre utilizar la nube gestionada de Modular, desplegar en tu propia nube mediante VPC o utilizar la versión autoalojada en tus propios contenedores.
¿Cómo funciona el modelo de precios de la plataforma Modular?
El coste varía según la modalidad, ofreciendo pagos por cada millón de tokens en puntos de enlace compartidos o tarifas por minuto para GPUs dedicadas.
¿Qué mejoras de rendimiento puedo esperar al usar Modular?
Modular ofrece una reducción significativa de la latencia con tiempos de respuesta inferiores a los quinientos milisegundos y ahorros de costes de hasta el setenta por ciento.
¿Es Modular compatible con los modelos de IA más populares del mercado?
Sí, permite ejecutar los últimos modelos de código abierto como DeepSeek y Llama, variantes ajustadas o incluso tus propios modelos personalizados.
¿Ofrece Modular soporte técnico especializado para empresas?
Sí, las ediciones de pago incluyen el apoyo de ingenieros expertos que ayudan a optimizar las cargas de trabajo y a realizar la migración de la infraestructura.
Precio de Modular y planes disponibles
Self-Hosted (Edición Community): Gratis.
Instalación mediante contenedor (menos de 700MB).
Incluye MAX y Mojo para ejecución en infraestructura propia.
Soporte a través de la comunidad en Discord y GitHub.
Compatible con diversas arquitecturas de GPU y CPU.
Licencia Comunitaria de Modular.
Modular Cloud (Shared Endpoints): Pago por uso basado en el consumo de tokens. Permite probar endpoints compartidos de forma gratuita inicialmente.
Sin gestión de infraestructura ni compromisos a largo plazo.
Acceso a modelos de frontera (DeepSeek V4, Llama, Qwen, etc.) mediante API compatible con OpenAI.
Precios variables por cada millón de tokens según el modelo (ej. DeepSeek V4: 1,74 $ entrada / 3,48 $ salida).
Métricas de uso y observabilidad integradas.
Modular Cloud (Dedicated Endpoints): Pago por minuto o por hora de GPU.
GPUs reservadas de diversos proveedores para un rendimiento constante.
Inferencia de última generación (SOTA) optimizada para cargas de trabajo exigentes.
Incluye ingenieros desplazados (forward-deployed) para el ajuste y optimización del despliegue.
Entorno seguro gestionado íntegramente por Modular.
Bring Your Own Cloud (BYOC): Pago por minuto de capacidad de GPU reservada.
Despliegue en la nube privada del cliente (VPC) o en servidores locales.
Los datos permanecen siempre dentro de la infraestructura del usuario para máxima privacidad.
Optimización específica de los pipelines y cargas de trabajo del cliente.
APIs personalizadas e ingenieros dedicados para soporte técnico y migración.
Enterprise: Precio personalizado mediante consulta con el equipo de ventas.
Control total de datos y opciones de despliegue híbrido.
Ejecución en cualquier hardware compatible (NVIDIA, AMD, AWS Trainium, Google TPU, etc.).
Capacidad de crear kernels personalizados en Mojo para arquitecturas de modelos novedosas.
Soporte de ingeniería avanzado y contratos personalizados.
Capturas de pantalla de Modular
Opiniones de usuarios sobre Modular
Escribir una reseña
Comprobando sesión...
Reseñas de Modular
Cargando reseñas...
Alternativas a Modular
Together Link
Conecta agentes de programación con modelos abiertos para reducir costes. Mantén tus herramientas y ajustes habituales mientras optimizas el consumo de tokens en cada sesión.
Optimus by Iacon Autonomics
Investigador autónomo que diseña experimentos y evalúa algoritmos para entrenar modelos de IA. Automatiza el ciclo de mejora en LLM, robótica y diversos sistemas complejos.
Nuclr Commander
Espacio de trabajo para ejecutar varios agentes de IA en paralelo con gestor de archivos. Soporta modelos locales o externos y supervisión remota desde el móvil.