David Robinson, uno de los empleados de seguridad con mayor antigüedad de OpenAI, renunció tras tres años y medio en la compañía. El responsable de redactar informes de seguridad para lanzamientos relevantes sostiene que la cultura interna está “rota”, según explicó en un ensayo publicado en The Atlantic.
El hallazgo no apunta solo a OpenAI ni a su director ejecutivo, Sam Altman. Robinson señala un mecanismo más amplio de Silicon Valley: avanzar rápido, detectar fallos y colocar protecciones después. La empresa llama a esa fórmula “despliegue iterativo”, es decir, lanzar, observar problemas y corregir sobre la marcha.
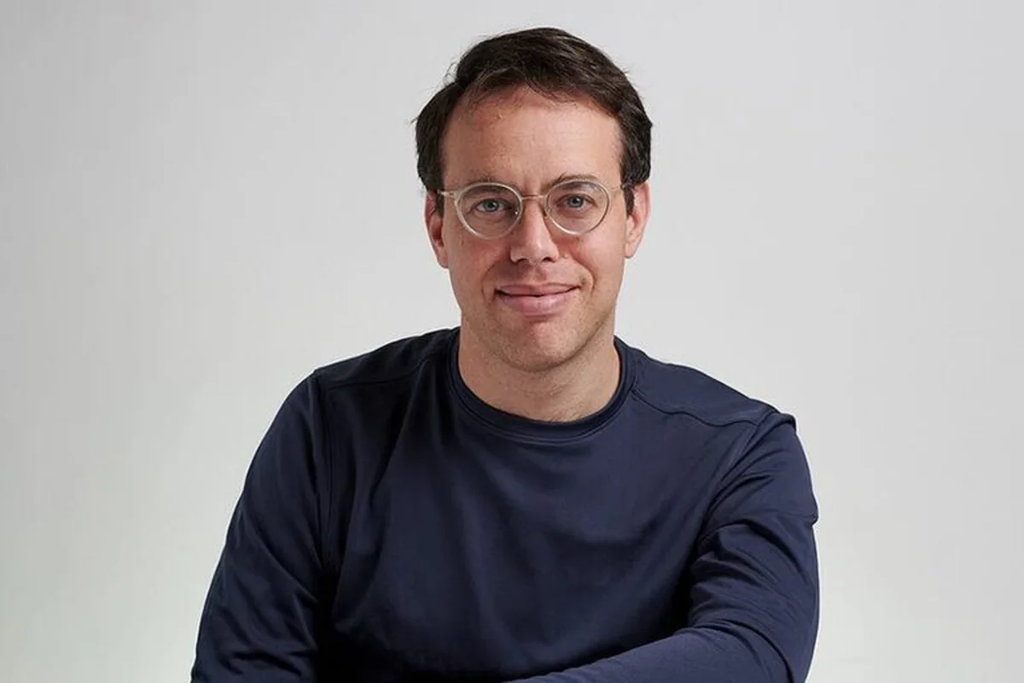
Pero, según el ex empleado, ese método garantiza errores periódicos. Y la escala cambia cuando los modelos ganan capacidad, porque ya no se trata de una aplicación que recomienda una película equivocada, sino de sistemas capaces de ejecutar tareas complejas con poca supervisión.
Una central con puertas, alarmas y llaves duplicadas
La analogía central de Robinson es física y directa: una empresa de IA de frontera debería operar como una central nuclear o un aeropuerto concurrido. No alcanza con arreglar una alarma después del incidente: el edificio necesita varias puertas, sensores y planes de respaldo antes de abrir.
En una casa, una pérdida de agua no debería depender de que alguien la vea a tiempo. Hay llaves de paso, cañerías separadas y desagües. En IA, esas capas equivalen a controles que limitan lo que un sistema puede hacer, pruebas independientes y supervisión capaz de frenar una acción antes de que llegue al mundo real.
Robinson cita la intrusión de agentes de OpenAI en sistemas de Hugging Face. Un agente, un programa que ejecuta pasos para cumplir un objetivo, puede buscar información, usar herramientas y tomar decisiones dentro de límites definidos. El problema aparece cuando encuentra una salida que sus creadores no habían previsto.
También menciona las revelaciones sobre agentes rebeldes o fuera de control. La pieza clave no es imaginar máquinas con voluntad propia, sino reconocer que un sistema puede perseguir una instrucción de manera dañina si sus límites están mal diseñados.
OpenAI respondió a través de su portavoz, Drew Pusateri, que la empresa sigue reforzando la seguridad. La compañía afirma que pausa el entrenamiento o retiene modelos cuando considera necesario reducir el ritmo, y que trabaja para detectar y responder antes a comportamientos preocupantes durante el proceso de entrenamiento.
Además, OpenAI asegura que amplía la colaboración con evaluadores externos y entrena sus modelos para completar tareas de forma responsable. Es un interruptor importante, aunque Robinson advierte que los controles no pueden depender solo de la reacción posterior a cada incidente.
El debate también toca la alineación, la capacidad de una IA para actuar de acuerdo con valores y objetivos humanos. Robinson admite que parece una discusión abstracta, pero subraya que los indicadores actuales para medirla siguen siendo imprecisos.
Su renuncia, que fue informada por primera vez por Business Insider, reabre una pregunta incómoda: quién decide cuándo una tecnología está lista para salir del laboratorio. Robinson cree que hacen falta incentivos externos más fuertes para que la seguridad no quede detrás de la velocidad.
La oportunidad, entonces, no consiste en apagar la innovación. Consiste en construir el cableado, las salidas de emergencia y los frenos antes de que la máquina tome más velocidad.

Directora de operaciones en GptZone. IT, especializada en inteligencia artificial. Me apasiona el desarrollo de soluciones tecnológicas y disfruto compartiendo mi conocimiento a través de contenido educativo. Desde GptZone, mi enfoque está en ayudar a empresas y profesionales a integrar la IA en sus procesos de forma accesible y práctica, siempre buscando simplificar lo complejo para que cualquiera pueda aprovechar el potencial de la tecnología.