A veces parece que el mercado de la inteligencia artificial es una carrera de locos hacia el abismo de los precios. Y nosotros, por supuesto, encantados. Alibaba Cloud acaba de dar un golpe sobre la mesa que va a hacer sudar a más de un competidor en occidente. Tras meses de especulaciones técnicas, la gigante asiática lanzó Qwen4-Max el 16 de noviembre de 2026 directamente en su plataforma Model Studio. Y no es una actualización menor, te lo aseguro. Estamos ante su nuevo modelo insignia multimodal equipado con una salvaje ventana de contexto de un millón de tokens. Casi nada.
Si miramos los números puros y duros, la estrategia es increíblemente agresiva. Según la lista de precios de Singapur, utilizar esta bestia cuesta 1,50 dólares por millón de tokens de entrada y 4,50 dólares para los de salida. Básicamente, estamos hablando de unas tarifas un 25 % más baratas que las de su predecesor inmediato, el Qwen3.8-Max. Han roto el mercado de la inferencia. Además, por si fuera poco, ofrecen un millón de tokens gratis durante 90 días para que los desarrolladores puedan trastear a gusto.
El modelo lo traga todo, pero prioriza el razonamiento
Evidentemente, un precio rebajado no sirve de nada si el modelo devuelve respuestas inútiles. Pero revisando la documentación del modelo, queda claro que Qwen4-Max es un auténtico todoterreno. Se traga texto, imágenes y vídeo como entrada, devolviendo texto enriquecido, formato JSON estructurado o ejecutando llamadas a funciones sin despeinarse. Está diseñado específicamente para lo que el mercado demanda hoy: programación dura, tareas complejas de oficina y sistemas basados en agentes autónomos.
Aquí viene la letra pequeña. El razonamiento avanzado del modelo viene activado por defecto en un nivel de esfuerzo alto. Y claro, pensar cuesta dinero. El modelo tiene un límite estricto de 262.144 tokens compartidos entre su proceso de deliberación interna y la respuesta final. Es decir, si le pides que reflexione demasiado, te comes el presupuesto de la respuesta. Así de crudo. Pagarás más tokens de salida cuanto más tiempo invierta la IA en buscar la solución correcta.
La magia del caché para no arruinarte con tus prompts
La realidad del sector es que el verdadero ahorro no está solo en el precio base, sino en dejar de repetirle a la máquina las mismas instrucciones una y otra vez. Para cargas de trabajo pesadas, la nueva guía de almacenamiento en caché de Qwen4 es oro puro para tu bolsillo. El sistema permite reutilizar prefijos idénticos de más de 1.024 tokens, como esos inmensos documentos de referencia o las densas instrucciones de sistema de tu prompt original.
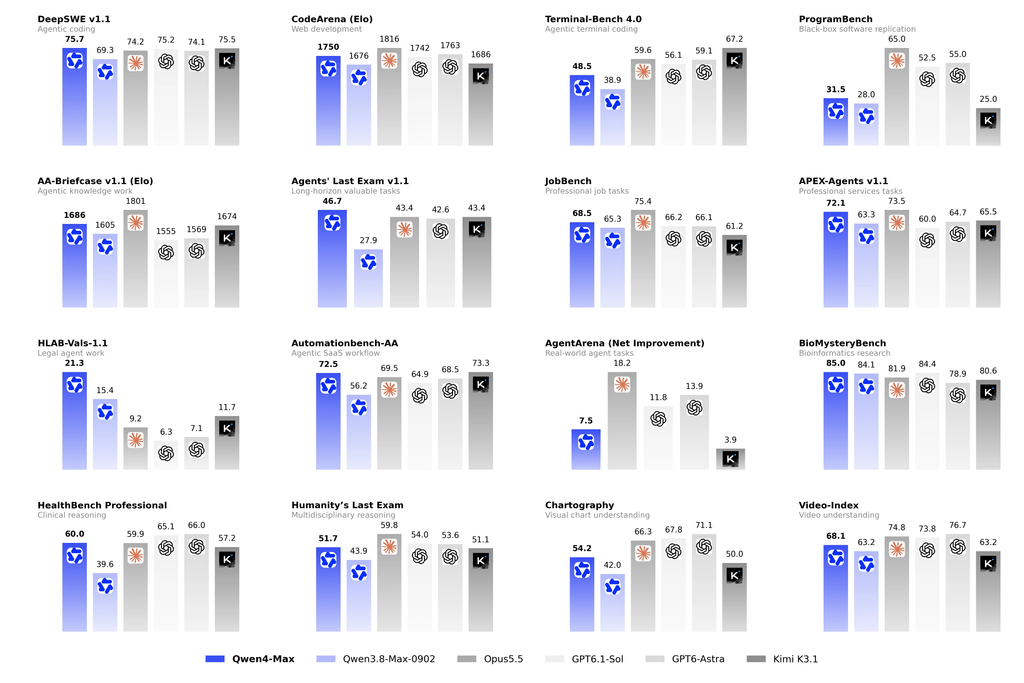
En la práctica, leer datos cacheados te cuesta la ridícula cifra de 0,075 dólares por millón de tokens en Singapur. Puedes optar por un caché explícito, que cuesta entre 1,875 y 3 dólares crearlo, pero te garantiza los aciertos absolutos durante cinco minutos o una hora.
O, si lo prefieres, puedes dejar que el sistema aplique el caché implícito de forma automática. Lo mires por donde lo mires, si vas a montar agentes que leen el mismo manual mil veces, esta es la clave de la rentabilidad. Solo ten en cuenta una cosa: el descuento se aplica únicamente a la entrada, la salida se cobra a precio completo.
Limitaciones regionales y un plan para devoradores de código
Pero no todo es barra libre en este despliegue. Si tenías en mente hacer un ajuste fino a medida (fine-tuning) o un despliegue personalizado, de momento te vas a quedar con las ganas, ya que no está soportado. Además, la jugosa inferencia por lotes se queda en exclusiva para la región de Pekín. El resto del planeta, con nodos en lugares como Virginia, Fráncfort o Tokio, tendrá que exprimir la API normal jugando con la configuración del caché para controlar el gasto.
Para los desarrolladores más puros, Alibaba ha sacado un as de la manga bastante curioso. Todo el potencial de este modelo se incluye en el Plan de tokens de la edición personal de Singapur. Hablamos de una suscripción pensada exclusivamente para machacar código de forma interactiva integrándose con herramientas top como Cursor, Claude Code o Qwen Code. Eso sí, las reglas son estrictas. Prohibido usar este pase para scripts automatizados o para montar el backend de tus aplicaciones comerciales.
Todo este ecosistema llega justo para tomar el relevo de su fase beta. El acceso temprano a Qwen4-Max-Preview llevaba abierto exclusivamente por suscripción desde el 11 de noviembre, pero desaparecerá definitivamente el día 25. Ya solo queda jugar con la versión definitiva.
Al final del día, Alibaba nos recuerda que la verdadera revolución de la IA no va solo de sumar billones de parámetros, sino de hacer que la tecnología sea económicamente viable. Lograr meter un millón de tokens en la coctelera, rebajar las tarifas un 25 % y ofrecer herramientas de control de caché tan agresivas es un claro aviso a navegantes. Tocará esperar para ver si OpenAI o Google deciden ajustar sus precios ante este movimiento oriental. La pelota está ahora en su tejado.
Me dedico al SEO y la monetización con proyectos propios desde 2019. Un friki de las nuevas tecnologías desde que tengo uso de razón.
Estoy loco por la Inteligencia Artificial y la automatización.