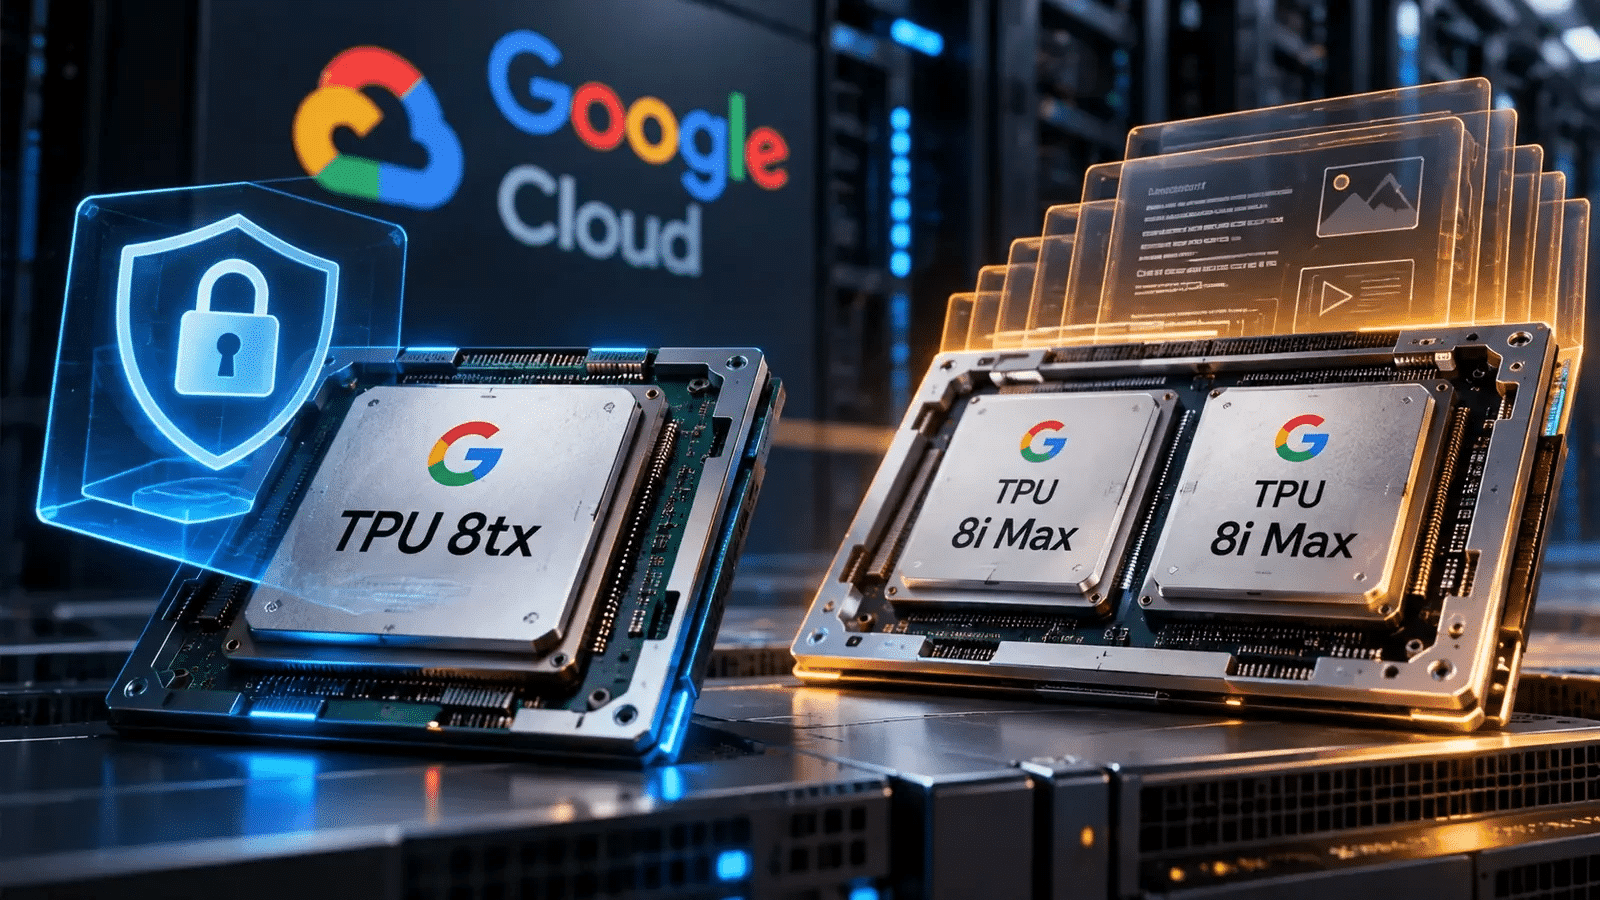
Google presentó dos nuevas variantes de sus unidades de procesamiento tensorial, o TPU (chips preparados para tareas de inteligencia artificial): TPU 8tx y TPU 8i Max. El hallazgo detrás de estos equipos es simple: la empresa busca que sus servicios de nube dependan menos de semiconductores fabricados por terceros.
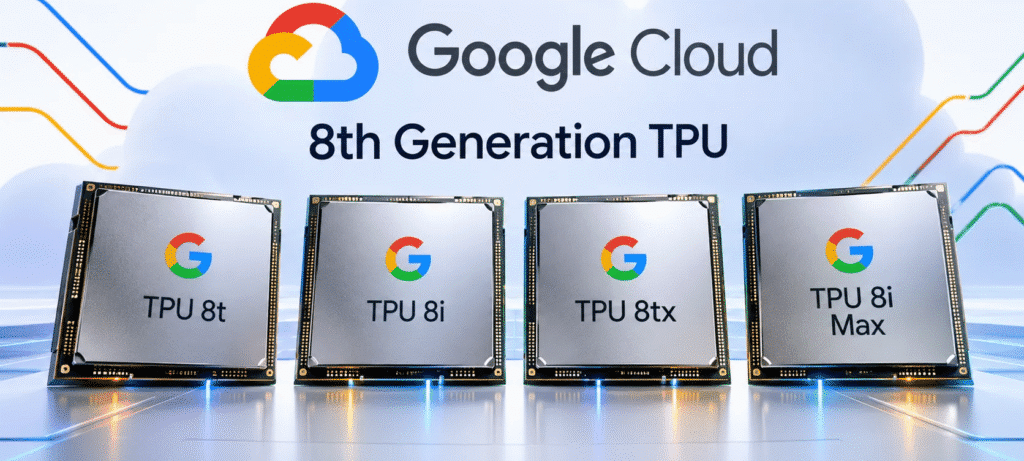
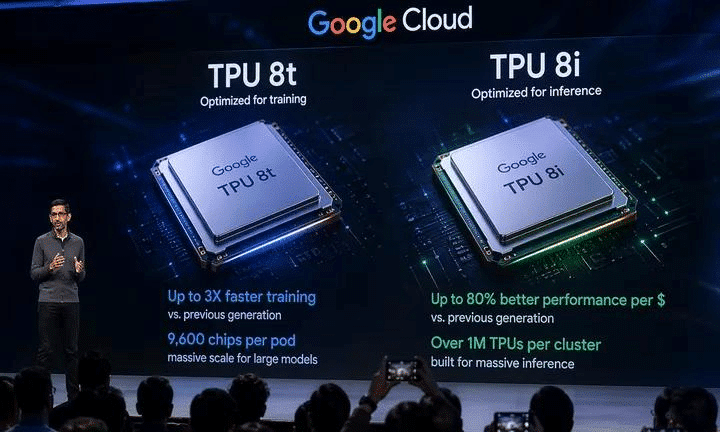
Ambos modelos pertenecen a la octava generación de TPU, anunciada en abril. Esa familia ya apuntaba a una mayor capacidad de inferencia (la respuesta que genera un modelo al recibir una consulta) y al entrenamiento de gran escala, pero ahora suma dos piezas clave para escenarios más exigentes.
El TPU 8tx fue desarrollado junto con AMD y se basa en el TPU 8t. Su mecanismo está pensado para el entrenamiento confidencial y para ejecutar modelos sin exponer datos sensibles ni los pesos del modelo, es decir, los ajustes internos que determinan cómo responde una IA.
Una caja fuerte y una biblioteca dentro del chip
La analogía doméstica ayuda a entender la diferencia. El TPU 8tx funciona como una oficina con caja fuerte incorporada: los documentos entran, se ordenan y se usan en el mismo lugar, sin tener que cruzar pasillos hacia otros dispositivos.
Google incorpora la seguridad directamente en el hardware, la parte física del sistema. Así, los datos de una compañía y los ajustes de su modelo pueden mantenerse aislados incluso mientras la inteligencia artificial trabaja con ellos.
Además, el chip incorpora una red personalizada para inferencia. Ese engranaje permite combinar el razonamiento, la evaluación de información para llegar a una respuesta, con el entrenamiento, el proceso de ajustar el modelo con nuevos datos. La oportunidad es importante para empresas que necesitan usar archivos propios sin trasladarlos entre distintos equipos.
En términos cotidianos, sería como corregir un manual de trabajo mientras todavía está guardado bajo llave. La IA puede destilar modelos, reducir un sistema grande para crear una versión más pequeña y específica, y entrenarlos sobre la marcha sin abrir innecesariamente el circuito de información.
El TPU 8i Max atiende otra necesidad. Reúne dos chips TPU 8i en un solo paquete y duplica la memoria, la potencia de procesamiento y el ancho de banda, la cantidad de información que puede circular en un tiempo determinado, frente a un TPU 8i individual.
Si el 8tx es una oficina segura, el 8i Max se parece a una biblioteca con el doble de estanterías y pasillos más amplios. Ese espacio adicional permite que un modelo conserve y revise una cantidad mayor de información durante una consulta, algo central cuando debe relacionar documentos extensos o instrucciones complejas.
El movimiento de Google revela una carrera que también incluye a Microsoft, Amazon, OpenAI y Anthropic. Estas compañías desarrollan chips propios y software especializado para reducir su dependencia de Nvidia, hoy una pieza clave del mercado de hardware para IA.
Para el usuario final, el cambio puede parecer lejano. Sin embargo, una infraestructura con más memoria, respuestas inmediatas y mejores resguardos puede traducirse en herramientas de IA más útiles para empresas, hospitales, bancos y servicios cotidianos. El nuevo cableado digital busca que la inteligencia artificial trabaje con más capacidad, pero también con la puerta mejor cerrada.

Directora de operaciones en GptZone. IT, especializada en inteligencia artificial. Me apasiona el desarrollo de soluciones tecnológicas y disfruto compartiendo mi conocimiento a través de contenido educativo. Desde GptZone, mi enfoque está en ayudar a empresas y profesionales a integrar la IA en sus procesos de forma accesible y práctica, siempre buscando simplificar lo complejo para que cualquiera pueda aprovechar el potencial de la tecnología.