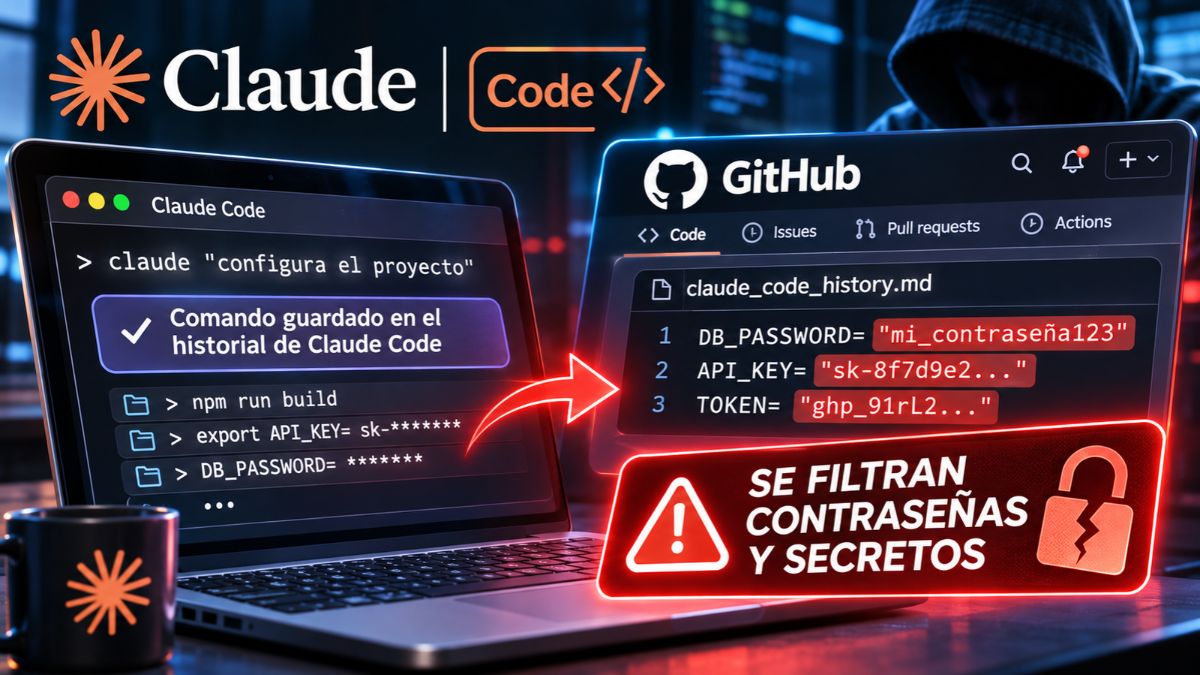
A todos nos fastidia que la inteligencia artificial nos pida permiso cincuenta veces para ejecutar un miserable comando de terminal. Por eso, cuando Anthropic lanzó su agente Claude Code con una opción de «Sí, y no vuelvas a preguntar», muchos programadores respiraron aliviados. Sin embargo, la comodidad extrema siempre suele cobrarse una factura oculta. Esta vez, el precio ha sido dejar expuestas credenciales críticas, bases de datos y claves maestras en repositorios públicos de GitHub.
El problema técnico de fondo es bastante lógico si entendemos cómo piensa el software actual. Los modelos predictivos como los LLM están programados inherentemente para generar la siguiente respuesta y continuar la interacción. Para evitar esas constantes interrupciones, el agente necesita memorizar los permisos. Cuando marcas la opción de confiar a ciegas, el sistema guarda el comando exacto en un archivo local llamado .claude/settings.local.json. Lo hace para poder reconocerlo inmediatamente en usos futuros. Un enfoque práctico, pero con un fallo catastrófico.
Si analizamos la ejecución real, la IA guardaba la instrucción literalmente en texto plano. Como descubrieron en Apiiro, esto significa que cualquier contraseña escrita en ese prompt quedaba almacenada sin cifrado alguno. Estamos hablando de filtraciones gravísimas: desde accesos a bases de datos corporativas hasta credenciales SSH, claves privadas, tokens y credenciales de AWS. Si alguien logra acceder a esos servicios de terceros, los costes económicos para la empresa afectada pueden ser devastadores. Un agujero de seguridad de manual.
La avalancha del ‘vibecoding’ ahoga los controles manuales
Por si fuera poco, a esta brecha de diseño hay que sumarle la fiebre absoluta por automatizar código. El concepto de vibecoding (programar charlando con la IA) ha disparado la actividad en las plataformas. Según el informe Octoverse 2026 de GitHub, en los doce meses previos a septiembre se alcanzó una cifra absurda: 17.900 millones de pushes y 34.300 millones de commits. Ese volumen de subidas de código pulveriza, de largo, el total combinado de los años 2024 y 2025. Una auténtica locura.

Básicamente, los datos demuestran que las máquinas están tomando el teclado a una velocidad que asusta. En septiembre de este año, más del 40 % de las pull requests originadas en la plataforma venían firmadas por un agente de IA. Solo seis meses antes, en marzo, esa cifra rondaba apenas el 17 %. Es decir, delegamos tanto y tan rápido que nadie se para a mirar qué archivos ocultos de configuración acaban subiéndose a internet por error. Y ahí es donde el archivo maldito de Claude Code sale a la luz.
Anthropic responde sin fechas fijas en el horizonte
Como era de esperar ante un escándalo de esta magnitud en foros de desarrollo, la compañía tuvo que salir a dar la cara. Curiosamente no hubo un frío comunicado de prensa de la start-up, sino que Boris Cherny, principal responsable de Claude Code, respondió en Hacker News directamente a los usuarios enojados. Y su defensa fue en parte culpar al propio ecosistema del usuario. Cherny argumentó que el archivo comprometido está configurado por el programa para ser excluido automáticamente de Git. Así de simple, no debería salir jamás de tu ordenador local.
Pero claro, la letra pequeña es que Cherny reconoció que el sistema nunca ha eliminado los secretos de esos comandos guardados. Según su versión, los archivos expuestos a todo el mundo fueron creados o subidos manualmente a la nube, o arrastrados por sincronizaciones masivas entre diferentes equipos de trabajo. Tú te haces una idea: la típica prisa del programador por subir a producción un viernes por la tarde. Si sincronizas todo sin un escaneo previo en tu pipeline, despídete de la seguridad perimetral de tu proyecto.
Mientras trabajan en un parche en condiciones, Anthropic pide calma y da instrucciones claras. Su consejo temporal es emplear el modo automático estándar de Claude Code, que toma sus propias decisiones pero detiene el proceso y te solicita instrucciones para acciones consideradas trascendentes. También urgen a los desarrolladores a encender las alertas de escaneo de secretos en sus repositorios de inmediato. El equipo ya testea internamente que la herramienta detecte estas fugas e incluso un escáner integrado en su propio núcleo.
Tocará esperar a ver si estas actualizaciones llegan a tiempo, porque todavía no han soltado ni una sola fecha de lanzamiento oficial para ninguna de las dos mejoras. Lo que está claro es que regalarle las llaves maestras a un asistente sintético exige protocolos humanos mucho más estrictos. La IA puede picar código casi sola sin que el hardware ni se inmute, pero los platos rotos financieros de una brecha en la nube los seguiremos pagando nosotros. Veremos si la competencia toma nota y blinda sus agentes antes del próximo desastre.
Me dedico al SEO y la monetización con proyectos propios desde 2019. Un friki de las nuevas tecnologías desde que tengo uso de razón.
Estoy loco por la Inteligencia Artificial y la automatización.