¿Cuánto tiempo se pierde en una oficina buscando un dato, revisando una tarea o esperando una respuesta antes de empezar el trabajo importante? Para los programadores, ese recorrido suele pesar tanto como escribir una línea de código.
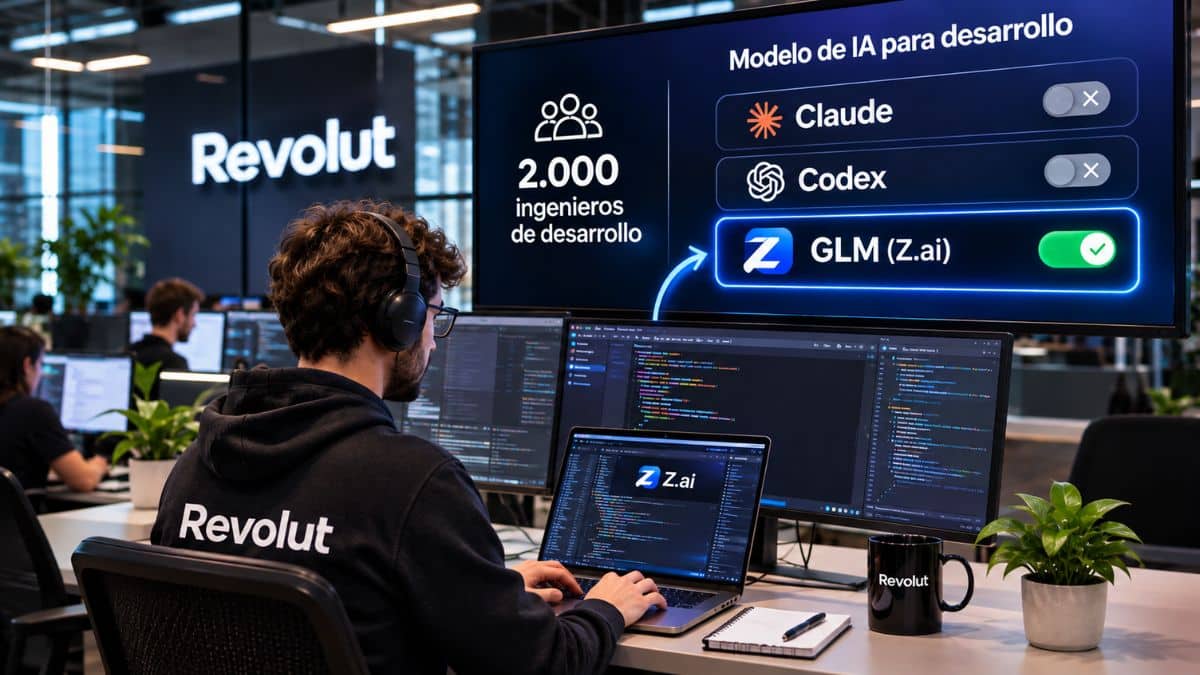
Revolut decidió cambiar esa rutina para sus cerca de 2.000 ingenieros. La fintech, con más de 80 millones de clientes, convirtió a GLM, el modelo de inteligencia artificial de pesos abiertos —parámetros disponibles públicamente— de la china Z.ai, en su asistente de programación principal.
Claude Code, de Anthropic, y Codex, de OpenAI, no desaparecieron. Sin embargo, Revolut los reserva para los problemas más complejos y con un presupuesto limitado. El hallazgo de la compañía es que un modelo alojado dentro de su propia infraestructura puede cubrir el trabajo cotidiano con una factura mucho menor.
David Abitbol, director de operaciones e infraestructura de IA de Revolut, explicó que el nuevo mecanismo redujo cerca de un 60% el tiempo de programación. Además, el tiempo de entrega, desde que se asigna una incidencia hasta que el cambio llega al sistema, bajó aproximadamente un 70%.
También te puede interesar:Revolut Regala un Año Gratis de ChatGPT Go, si Cumples Estas CondicionesAbitbol contó durante la GTC de Nvidia en Berlín que el cuello de botella no estaba solo en escribir código, sino en todas las tareas que lo rodean.
Una central eléctrica propia para la IA
La analogía clave se parece a la diferencia entre pagar cada vez que se enciende una luz y tener una pequeña central eléctrica en el edificio. Los modelos de frontera —las IA más potentes y comerciales— cobran según el uso. Revolut, en cambio, ejecuta GLM en sus propios servidores.
La empresa pasó de alquilar electricidad por cada tarea a mantener encendido un generador para todo el equipo. Esa pieza clave modifica la relación con la herramienta: los ingenieros disponen de tokens ilimitados, las unidades de texto que procesa la IA, sin temer que el presupuesto se agote a mitad de mes.
Antes, Revolut había incorporado Gemini de Google en enero. Según Abitbol, esa etapa mejoró el tiempo de entrega un 10% y el de programación un 20%. Después llegó Claude Code, con un límite de 300 dólares mensuales por ingeniero, pero esa reserva no alcanzaba para usarlo durante todo el mes.
Con GLM, la IA dejó de ser una ayuda ocasional. Los equipos la usan para buscar información en Confluence, localizar conversaciones en Slack y ordenar incidencias en Jira. Es decir, también atiende el cableado invisible del trabajo: papeles, mensajes y solicitudes que retrasan una solución.
Revolut sirve el modelo con unas 56 GPU de Nvidia, procesadores diseñados para cálculos de IA. El coste combinado ronda los 30 céntimos por cada millón de tokens y, sobre todo, la infraestructura tiene una factura fija en lugar de crecer con cada consulta.
El resultado, según la empresa, es un coste cercano a una décima parte del que tendría con modelos comparables de frontera.
Velocidad, privacidad y supervisión humana
La instalación no funcionó como un interruptor perfecto desde el primer día. En junio, el sistema superaba los diez segundos de latencia, el tiempo que tarda en responder, con cuatro solicitudes por segundo. Tras optimizar el despliegue sin sumar GPU, Revolut superó las ocho solicitudes por segundo con respuestas inferiores a 1,8 segundos.
Abitbol señala que la eficiencia no exige comprar hardware de forma automática. Recomienda controlar la caché, una memoria temporal que evita repetir trabajo, y usar FP4, un formato de cálculo menos preciso que libera capacidad de las GPU, frente a FP8. La diferencia puede ahorrar alrededor del 40% de esa capacidad.
El uso de un modelo chino también abre dudas de privacidad en una entidad financiera regulada. Revolut aclara que solo utiliza los pesos públicos de GLM y los aloja en servidores propios o de proveedores de la Unión Europea y Estados Unidos. Según la firma, ningún dato se envía a un servicio chino.
Además, sus agentes de IA operan en una sandbox (entorno aislado con límites), donde algunos comandos están permitidos y otros bloqueados. Siempre hay una persona supervisando el proceso. Para imágenes, GLM no interviene: Revolut deriva esa tarea a opciones más económicas, como Gemini Flash.
La oportunidad no consiste en dejar sola a la máquina. Consiste en poner un engranaje útil dentro de la casa, con puertas cerradas, controles visibles y personas que todavía conservan la llave.

Directora de operaciones en GptZone. IT, especializada en inteligencia artificial. Me apasiona el desarrollo de soluciones tecnológicas y disfruto compartiendo mi conocimiento a través de contenido educativo. Desde GptZone, mi enfoque está en ayudar a empresas y profesionales a integrar la IA en sus procesos de forma accesible y práctica, siempre buscando simplificar lo complejo para que cualquiera pueda aprovechar el potencial de la tecnología.