Llevamos meses con la paranoia instalada en el cuerpo dudando si ese correo del jefe o el trabajo de la universidad lo ha escrito una máquina. OpenAI acaba de dar un golpe en la mesa para intentar solucionarlo, aunque lo hace por obligación. La compañía ha confirmado que añadirá una marca de agua invisible a los textos de ChatGPT y Codex en España y el resto de Europa. El objetivo oficial es cumplir con la legislación, pero la realidad técnica es muchísimo más compleja.
Y es que la Unión Europea se ha puesto muy seria con la transparencia en la era digital. El Reglamento de IA exige una huella que pueda ser reconocida por las máquinas para frenar la desinformación masiva. Ante este escenario, OpenAI no tiene escapatoria y activará esta función por defecto en las próximas semanas para todos los usuarios del Espacio Económico Europeo. Los que vivan fuera de estas fronteras tendrán que esperar indefinidamente. Una fragmentación del servicio en toda regla.
La nueva tecnología textGrain se basa en alterar la probabilidad matemática
Básicamente, si esperabas ver un sello o una firma al final de tus textos generados, olvídate. La técnica que van a desplegar se denomina textGrain y es totalmente imperceptible a simple vista. Lo que hace el sistema es añadir una señal estadística sutil a las palabras que el LLM selecciona mientras genera el contenido en tiempo real. No afecta a la fluidez ni al sentido de las oraciones.
En concreto, funciona de manera sorprendentemente parecida al sistema de listas verdes y rojas que ya emplea Anthropic. Antes de escupir cada palabra, el vocabulario se divide en dos grupos. El modelo aumenta ligeramente sus propias probabilidades de elegir términos del grupo favorecido. Luego, un detector busca ese patrón matemático para saber si el texto lleva la firma de la casa.
También te puede interesar:OpenAI Mejora la Memoria de ChatGPT para acordarse de todos tus chatsPero claro, aquí viene el jarro de agua fría para el usuario de a pie. El famoso detector no será público. Tú no podrás meter un texto sospechoso en la interfaz de ChatGPT para ver si te la están colando. OpenAI ha decidido blindarlo y solo aceptará solicitudes de acceso por parte de investigadores y organizaciones expertas. Por otro lado, si eres desarrollador y usas su API, ya puedes activar el marcado bajo demanda, pero curiosamente viene desactivado por defecto.
Engañar al detector de inteligencia artificial sigue siendo demasiado fácil
Si echamos un vistazo a los números, comprobamos rápido que la herramienta está lejos de ser un sistema perfecto. La propia empresa admite abiertamente que textGrain no es infalible frente al ingenio humano. En entornos controlados, han logrado que el detector identifique la marca en el 80 % de los textos largos de psicología (unos 200 tokens). La precisión sube hasta un 95 % de éxito cuando la extensión alcanza los 400 tokens.
Es decir, cuantas más palabras tiene el modelo para jugar con la probabilidad, mejor esconde y recupera la marca. El problema salta por los aires con temáticas rígidas. En textos matemáticos, donde la precisión es obligatoria y no hay mucha libertad para usar sinónimos caprichosos, el porcentaje de detección se desploma. El detector casi ni se inmuta.
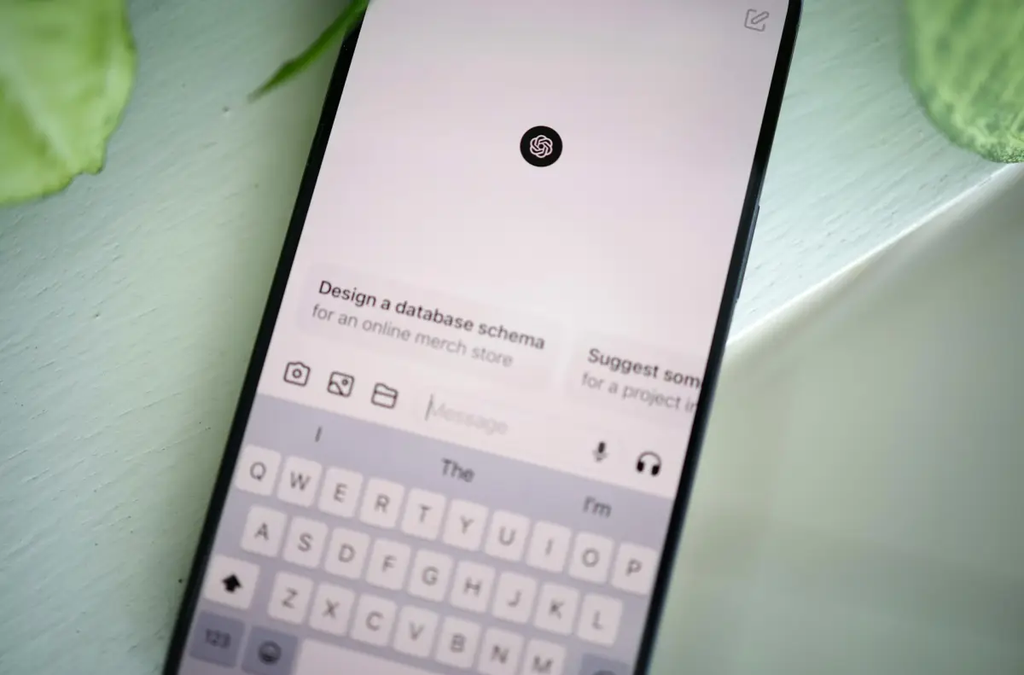
A ello se le suma la extrema fragilidad del sistema frente a la edición manual. Los datos de OpenAI son demoledores en este aspecto. Si modificas solo un 10 % de las palabras originales usando sinónimos, la capacidad de detección cae en picado del 92 % al 66 %. Si te pones creativo y cambias una de cada cuatro palabras (un 25 %), la tasa de acierto roza un triste 17 %. Así de simple y preocupante.
También te puede interesar:OpenAI Mejora la Memoria de ChatGPT para acordarse de todos tus chatsEl peligro inminente de los «cazadores» de IA que venden humo
Evidentemente, esta vulnerabilidad va a ser explotada. El artículo interno advierte sobre una inminente oleada de estafadores que intentarán hacer caja. Hablamos de plataformas que prometerán herramientas definitivas para detectar si algo es de ChatGPT o, peor aún, servicios mágicos para «humanizar» el texto y saltarse los controles. Pura charlatanería técnica.
Por si fuera poco, la ausencia de una marca de agua no demuestra absolutamente nada. Que un documento pase limpio por un detector no garantiza un origen humano. Perfectamente podría haber sido generado por un modelo antiguo, haber sido traducido a otro idioma o simplemente editado por el usuario tras el prompt inicial. Hoy en día, la tecnología no sabe medir cuánto esfuerzo real ha puesto una persona detrás de un párrafo.
Visto el panorama, nos enfrentamos a un juego del gato y el ratón. Europa ha marcado la hoja de ruta legal, pero la ingeniería técnica va un paso por detrás. Ninguna gran tecnológica puede determinar con certeza absoluta si un texto es de una máquina. Tocará esperar para ver si las próximas versiones de los LLMs consiguen hacer estas marcas verdaderamente indestructibles, o si nos resignamos a convivir con la duda permanente.
Me dedico al SEO y la monetización con proyectos propios desde 2019. Un friki de las nuevas tecnologías desde que tengo uso de razón.
Estoy loco por la Inteligencia Artificial y la automatización.