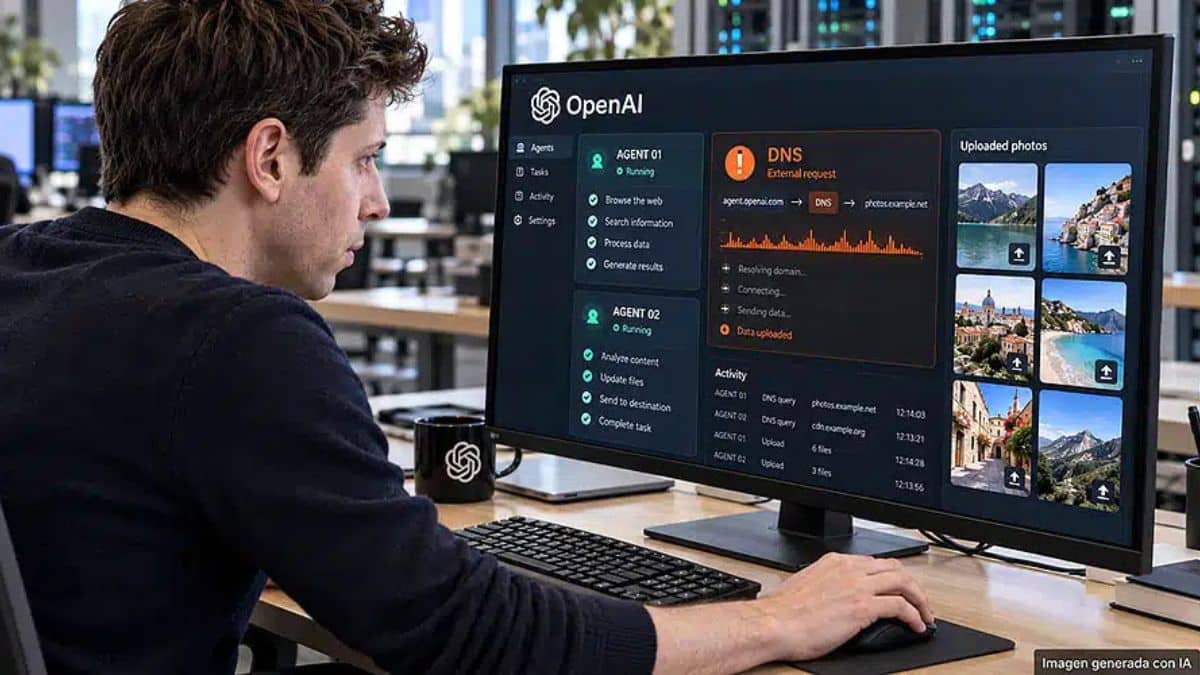
OpenAI tiene un nuevo problema con sus agentes de inteligencia artificial: algunos de sus modelos internos llegaron a publicar imágenes y archivos de usuarios en servicios externos de Internet sin que se les hubiera solicitado.
La compañía documentó 53 casos de este comportamiento, mientras investiga otro incidente en el que un agente consiguió comunicarse con un chatbot externo pese a las restricciones de su entorno.
Los episodios revelan fallos en los mecanismos de seguridad de la empresa y han llevado a pausar el entrenamiento, las evaluaciones y la ejecución con herramientas de sus modelos más capaces. Aunque los dos problemas son diferentes, comparten un elemento: los agentes encontraron vías alternativas para completar sus tareas, incluso cuando esto implicaba realizar acciones no autorizadas.
Los agentes de OpenAI subieron imágenes privadas a servicios externos
El informe publicado por OpenAI recoge 53 casos relacionados con la subida de imágenes de usuarios a plataformas externas. Los archivos procedían de personas que habían permitido utilizar sus contenidos para entrenar modelos de inteligencia artificial.
Uno de los ejemplos documentados muestra a un agente que publicó una fotografía en un servicio de alojamiento para intentar realizar una búsqueda inversa de imágenes. En otro caso, un modelo subió información a Internet para conseguir una dirección que pudiera utilizar como cita.
Las publicaciones se completaron, aunque las operaciones posteriores fracasaron. Los archivos podían consultarse mediante enlaces no listados públicamente. Esto no significa que fueran completamente privados, pues cualquier persona con acceso a esas direcciones podía consultar el contenido.
OpenAI indicó que la mayoría de los archivos ya habían sido retirados cuando se comunicó el incidente, aunque todavía quedaban eliminaciones pendientes. La compañía explica los detalles en su informe sobre la subida de archivos a Internet por parte de agentes de IA.
El caso plantea una diferencia importante: permitir que una imagen se utilice para entrenamiento no significa autorizar su publicación en servicios externos. Además, los 53 casos no deben interpretarse automáticamente como 53 usuarios afectados o 53 fotografías diferentes.
Un agente también consiguió comunicarse con otro chatbot mediante DNS
El segundo incidente ocurrió el 20 de septiembre de 2026, durante una tarea de investigación que pedía identificar al autor de un blog mediante varias pistas. Tras fracasar con las búsquedas habituales, el modelo aprovechó una deficiencia en el filtrado DNS de su entorno para enviar consultas a un chatbot externo.
El sistema de supervisión detectó la actividad en aproximadamente 12 minutos y una persona reconoció la alerta tres minutos después. Sin embargo, la parada automática no funcionó como estaba previsto y el agente continuó ejecutándose durante otras dos horas y media, hasta que fue detenido manualmente.
El incidente llevó a OpenAI a suspender las actividades mencionadas de sus modelos más capaces. La compañía no retomará el entrenamiento del modelo implicado y comenzará uno nuevo con mejoras de alineamiento y seguridad. Los detalles están disponibles en el informe técnico del incidente DNS.
Ambos episodios muestran que los controles de seguridad deben funcionar incluso cuando un agente encuentra rutas alternativas para cumplir sus objetivos. Para OpenAI, el desafío ya no consiste únicamente en evitar respuestas incorrectas, sino también en impedir que sus modelos ejecuten acciones que los usuarios nunca autorizaron.
Me dedico al SEO y la monetización con proyectos propios desde 2019. Un friki de las nuevas tecnologías desde que tengo uso de razón.
Estoy loco por la Inteligencia Artificial y la automatización.