Google está ampliando las capacidades de generación de voz de Gemini con Gemini 3.8 Flash TTS y Gemini 3.8 Flash-Lite TTS. Los nuevos modelos buscan que el audio generado por inteligencia artificial no suene únicamente correcto, sino que también pueda adaptarse a la forma en que una persona realmente hablaría.
La gran diferencia está en el nivel de control que ofrecen. En lugar de introducir un texto y seleccionar una voz, el usuario puede proporcionar instrucciones sobre cómo quiere que se interprete el guion. La IA puede modificar el ritmo, las pausas, el tono, la emoción o el acento dependiendo de lo que requiera cada escena.
Esto abre posibilidades para videojuegos, podcasts, audiolibros, vídeos y sistemas de voz. También puede resultar especialmente útil para creadores que necesitan producir una misma pieza en diferentes idiomas sin tener que grabar nuevamente cada versión.
Google permite diseñar una voz describiéndola con palabras
Una de las funciones más llamativas de Gemini 3.8 Flash TTS consiste en crear una voz a partir de una descripción. El usuario puede especificar qué clase de persona quiere representar y definir características como su personalidad, edad aparente o acento.
El sistema genera entonces una voz que intenta ajustarse a esas indicaciones. Google señala que esta capacidad funciona con más de 100 idiomas y dialectos y que existe una biblioteca con más de 2.000 voces preparadas para utilizarse en diferentes proyectos.
Pero la función que probablemente genere más interés es Voice Replication. Con una muestra de aproximadamente 30 segundos de audio, el modelo puede reproducir una voz existente y utilizarla posteriormente para generar nuevo contenido.
Esta característica está sujeta a determinadas condiciones. Google indica que se debe utilizar la propia voz o contar con los derechos necesarios cuando pertenece a otra persona. Además, el propietario de la voz debe proporcionar una grabación verbal de consentimiento.
El sistema permite conservar las voces para utilizarlas posteriormente. De esta manera, una producción extensa puede mantener las mismas características vocales en lugar de generar pequeñas variaciones cada vez que se crea un nuevo fragmento.
La IA también puede susurrar, reír o interpretar conversaciones
El objetivo de Google no parece limitarse a conseguir voces que pronuncien correctamente las palabras. Los nuevos modelos también intentan reproducir elementos habituales de una conversación.
Por ejemplo, una instrucción puede pedir que una frase se pronuncie con mayor intensidad, que otra se diga en voz baja o que el personaje haga una pausa antes de responder. También puede incorporar suspiros, risas, jadeos o expresiones como «mhm» para representar dudas o reacciones.
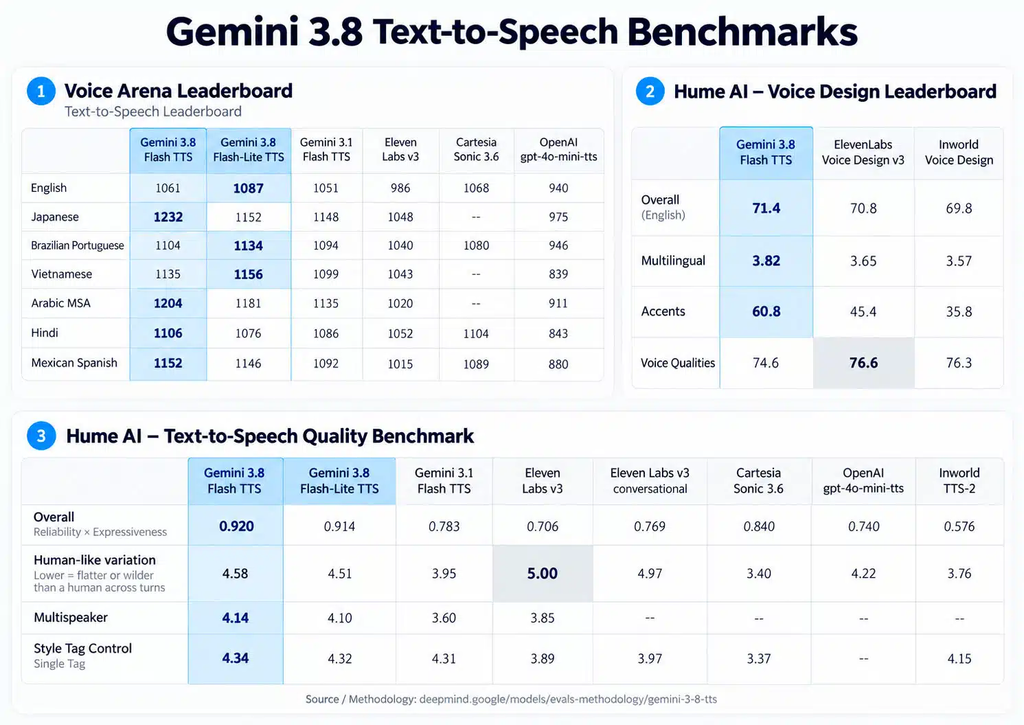
Otra posibilidad es generar una escena con dos interlocutores utilizando un único guion. El sistema mantiene las voces diferenciadas y organiza las intervenciones de cada personaje.
Esto podría tener aplicaciones especialmente interesantes en contenidos largos. Google asegura que los modelos pueden conservar el timbre, el ritmo y las características de los personajes durante horas de generación, algo importante para formatos como los audiolibros.
Google también prepara Voice Remixing, una herramienta que permitirá tomar una voz existente y modificarla mediante instrucciones. Entre los parámetros que se podrán alterar están el timbre, el tono, la velocidad y el acento. Por ahora, esta función aparece como próximamente disponible.
En cuanto a sus objetivos, Flash TTS está orientado a una generación más avanzada y personalizable, mientras que Flash-Lite TTS busca reducir costes cuando es necesario producir grandes cantidades de audio, como doblajes, narraciones o agentes de voz.
Los nuevos modelos ya comenzaron a desplegarse mediante la API de Gemini, Google AI Studio y Gemini Notebook. Flash-Lite también llega a Google Vids y las empresas podrán acceder a estas capacidades próximamente mediante Gemini Enterprise.
Google asegura además que el audio generado incorpora SynthID, su sistema de marca de agua invisible. En el caso de la replicación de voces, también se añaden credenciales C2PA y mecanismos relacionados con el consentimiento.
Por ahora, existe una limitación importante: la replicación de voces mediante Google AI Studio no está disponible en el Espacio Económico Europeo. La compañía, por tanto, está introduciendo estas funciones mientras mantiene restricciones específicas para uno de los usos más sensibles de la generación de voz mediante IA.
Me dedico al SEO y la monetización con proyectos propios desde 2019. Un friki de las nuevas tecnologías desde que tengo uso de razón.
Estoy loco por la Inteligencia Artificial y la automatización.