Europa no quiere ser un simple espectador en la guerra de la inteligencia artificial. Mientras los gigantes de Silicon Valley pelean por ver quién tiene el chatbot más charlatán, desde Alemania acaba de aterrizar un misil directo a la línea de flotación corporativa. Hablamos de Kolibri, un modelo brutal diseñado obsesivamente para quien no puede permitirse filtrar ni un solo byte a la nube externa.
El secreto está en los pesos abiertos y la soberanía
Y es que Aleph Alpha acaba de poner sobre la mesa algo que administraciones públicas e industrias europeas llevaban tiempo pidiendo a gritos. Han lanzado este modelo bajo la permisiva licencia Apache 2.0. Básicamente, te lo descargas desde Hugging Face, lo instalas en tu propia infraestructura y cortas el cable de internet. Ningún dato sensible viaja a servidores de inferencia de terceros. Una jugada maestra para la soberanía tecnológica.
Si miramos los números puros, las cifras imponen respeto inmediato. Estamos ante una bestia algorítmica de 78.100 millones de parámetros en total. Pero claro, mover eso en local para cada consulta sería una auténtica pesadilla financiera y técnica. Para solucionarlo, han tirado de una avanzada arquitectura Mixture-of-Experts (MoE) que únicamente activa 3.460 millones de parámetros por cada token procesado. Eficiencia pura y dura.
De hecho, el diseño de sus entrañas es una virguería técnica pensada para no quemar tus tarjetas gráficas. El cerebro de Kolibri cuenta con 384 expertos, de los cuales solo seis se despiertan simultáneamente para trabajar en cada palabra. A ello se le suma un truco fantástico en sus 50 capas de red neuronal. Diez de ellas usan atención completa, mientras las otras cuarenta aplican una ventana deslizante de 512 tokens para contener radicalmente los costes operativos. Así de simple.
Un millón de tokens y la obsesión por no mentir
Lo que realmente va a cambiar cómo trabajamos con documentos es su monstruosa capacidad de memoria a corto plazo. Aunque la adaptación base alcanzó los 256.000, Aleph Alpha permite configuraciones para exprimir hasta un millón de tokens de contexto. Te haces una idea, ¿verdad? Puedes meter de golpe bases de datos legales enteras, manuales de ingeniería aeronáutica o miles de historiales internos, y la IA ni se inmuta.
Evidentemente, devorar tanta información no sirve de absolutamente nada si el modelo acaba inventándose la mitad de las conclusiones. Aquí es donde entra la fundamentación en evidencias, el eje central de este lanzamiento. Han entrenado activamente al sistema para que aprenda a abstenerse de responder si no está seguro. Literalmente, le han enseñado a callar.
Para lograr esta proeza de seguridad, utilizan el protocolo Merlin-Arthur de Aleph Alpha, un procedimiento matemático súper riguroso que obliga al modelo a verificar sus pruebas antes de soltar un texto. Los resultados de su test interno no dejan lugar a dudas. Kolibri evitó escupir una respuesta falsa en el 44 % de los escenarios problemáticos, frente al pobre 14,8 % que lograba su predecesor. Un salto espectacular.
Músculo alemán en el cuadrilátero de los LLM
Por si fuera poco, la fase de entrenamiento ha sido un auténtico despliegue de fuerza industrial. Han fundido 768 bestias B200 de NVIDIA durante 21 días frenéticos. En total, el modelo ha devorado cerca de 24 billones de tokens entre el preentrenamiento y las fases de refinamiento largo. Como curiosidad muy intencionada, el 21,3 % de esos datos de preentrenamiento estaban íntegramente en alemán.
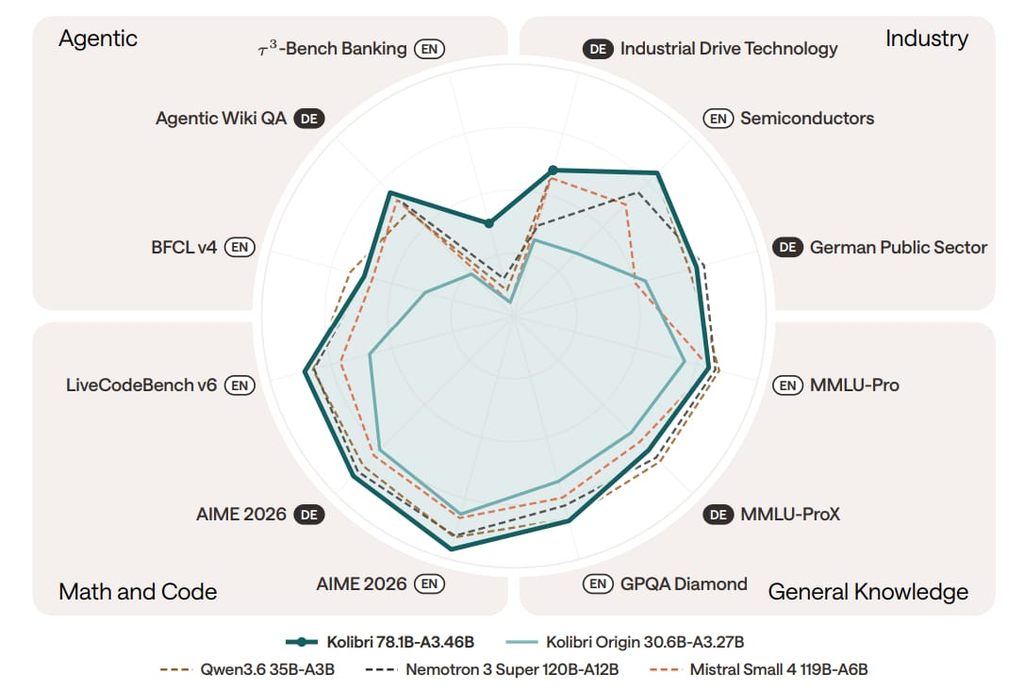
Esto tiene todo el sentido del mundo si quieres dominar la industria europea del motor o los semiconductores. Su tokenizador de 128.000 entradas está diseñado a medida para conservar intactas las eternas palabras compuestas alemanas. Según la propia publicación oficial de la empresa, con este enfoque bilingüe logran igualar a rivales que cuadriplican su tamaño en razonamiento matemático y programación.
La letra pequeña es que estos excelentes números (un 96,9 en el benchmark AIME 2025 y un 85,9 en LiveCodeBench) vienen de evaluaciones ejecutadas internamente por la misma empresa. Han usado siempre el nivel más alto de sus cuatro modos de razonamiento. Habrá que ver si aguanta el tirón cuando la comunidad empiece a testearlo sin piedad, pero las promesas son altísimas.
Si tu organización cumple con los requisitos técnicos, ya puedes echarle el guante hoy mismo. Todo el ecosistema está listo para su despliegue local usando un complemento vLLM específico creado por los propios desarrolladores alemanes.
Europa empieza a demostrar que no necesita depender eternamente de la caja negra de las grandes tecnológicas estadounidenses. Tener modelos potentes, transparentes y totalmente auditables en tus propios servidores es un golpe en la mesa. La pelota está ahora en el tejado de las administraciones para decidir si abrazan esta tecnología o siguen mirando desde la barrera.
Me dedico al SEO y la monetización con proyectos propios desde 2019. Un friki de las nuevas tecnologías desde que tengo uso de razón.
Estoy loco por la Inteligencia Artificial y la automatización.